2026年10月1日、SunoがSpeechのパブリックベータ版を公開した。テキストを書けば、AIが背景音楽付きの音声を同時に生成し、完成形のオーディオトラック1本をそのまま出力してくれる。ナレーションとBGMはこれまで二工程だった——まずテキスト読み上げでドライボイスを作り、手動でBGMを選んでタイミングを合わせる。Sunoはこれらを単一モデルにまとめ、ワンショットで生成する。ポッドキャストやオーディオブック、広告ナレーションなら、原稿から完成音声までの距離が数分まで縮まる。条件として、本人も認めているとおり、まだベータ段階である。
一文書くだけで、声と音楽が同時に出てくる
Sunoのチーフプロダクトオフィサー、Jack Brodyの名でSpeechのパブリックベータ版が発表され、ウェブ版とモバイル版が同時に公開された。これに先立つ約1か月、この機能は一部のユーザーにしか開放されていなかった。
従来、ある音声にBGMを添えるには、まずテキスト読み上げツール「TTS」(テキスト読み上げツール。一般的な「機械ナレーション」がこれにあたる)で音声を生成し、手動でBGMを重ねる必要があった。Sunoはこれら二つの工程を単一モデルに統合し、人声とBGMを一本のオーディオトラックとして一度に出力する。
Brodyは発表文で次のように言い切っている——「the first audio model that generates voice and music together as one cohesive track」、つまり人声と音楽を一本の完全なトラックとして生成する初のオーディオモデルである、と。Sunoはこれを"creative entertainment"と呼ぶ。より多くの人に「アイデアをものにする」体験を楽しんでもらうこと。音楽はその出発点にすぎない。
二工程はどうやって一工程に畳み込まれるのか?
SunoのSpeechは、まず音声を合成してからBGMを重ねるわけではない。人声とBGMは入力から出力まで一回の経路を通り、モデル内部で揃えられる。
ユーザーがやることは三つだけ。Sunoにテキストを書く(アイデアの一行でも、詩でも、原稿でも可)→ 声と音楽スタイルを選ぶ → モデルが人声とBGMを同時に合成して出力する。音声とBGMはモデル内部であらかじめリズム・情绪・間の取り方が揃えられ、最後に出てくるのは一本のファイルであり、ユーザーが手動でミックスする二本のトラックではない。
ここでの鍵は「単一モデルでまとめて生成する」点にある。従来、BGM付きの人声を作る一般的な流れは、TTS(テキスト読み上げ。原稿をドライボイスにする)でドライボイスを出し、音楽ライブラリからBGMを選び、編集ソフトでタイミングや音量、情绪を手動で調整する、というものだった。Speechはこの組み合わせ工程を飛ばす。ビート、人声の抑揚、BGMの情绪の流れはモデルがワンショットで決める。
二つの入力モードで習熟度の異なるユーザーに対応する。Simpleモードは「落ち着いた男性ボイスで深夜のモノローグを読み、BGMはlo-fiで」のように説明を書くだけ。モデルが人設と編曲を自動で補完する。Advancedモードは完成した原稿をそのまま貼る方式で、voice gender、speech style、voice varietyといったパラメータをより細かく制御できる。生成上限は約8分。短めのポッドキャスト1本分や商品ナレーション1本分にちょうど収まる。
出典:Suno公式の製品説明
出典:Suno公式(Brody名義の発表文)
出典:Sunoを引用した第三者報道。独立した検証は確認できず
従来のTTSツールが出力するのはドライな人声で、BGMは別計算。CapCut(剪映)やSunoの従来のワークフローは「先に音楽を作り、後からナレーションを重ねる」方式だった。Speechはこの二工程を一工程に畳み込む。代償として、BGMディテールの手動制御権は弱まる。ただポッドキャスト、オーディオブック、広告ナレーションのように「原稿が固定で、BGMは内容に寄り添う」用途なら、原稿から完成音声までの距離は数分に縮まる。
英国なまりがオーストラリアに流れ、「とても」ドラマチックな間も実際に起こる
ベータは本当にまだベータだ。SunoのCPOがブログで二つの問題点を明かしている——英国なまりがオーストラリアなまりにずれる、ドラマチックな間が「とても」ドラマチックになりうる。
新モデルのローンチ時、一般的にはまず発表告知が出され、後から「既知の問題」メールが届く。Sunoはこの二件を同じ段落に押し込んだ——'And beta really does mean beta.'。続けて英国なまりがオーストラリアなまりに揺れることを認め、劇的な間については 'may be very dramatic' と自虐してみせる。「製品はまだ発展途上」とローンチ文に書き込むこと自体が珍しい。
英国なまりのずれは「なまりの安定性」の問題——テキスト読み上げ合成(TTS)(テキストを自然な人声に変換する技術)で頻出する失敗パターンで、たいていは学習データ内の特定なまりのサンプル不足が原因となる。Sunoは理由を説明せず、「ずれる」とそのままユーザーに伝えている。'very' を強調斜体にしたのはBrodyの計算だろう——「音声が固まったかと思うほどの長さの間が入るかもしれない」と语气で読者に伝えるためだ。
対照的に、SoraやElevenLabsはローンチ時、機能の見せ場を打ち出してから免責を行う構成だった。Sunoは逆で、弱点を先に明かし、それから触ってくれと言う。この順序は、betaのハードルを書き換えているように見える。
瞑想、寝かしつけのエピソード、激励の言葉——Sunoが狙うのは音楽だけではない
瞑想、寝かしつけのエピソード、激励の言葉、詩の朗読——いずれも音楽ではないが、声を必要とする。
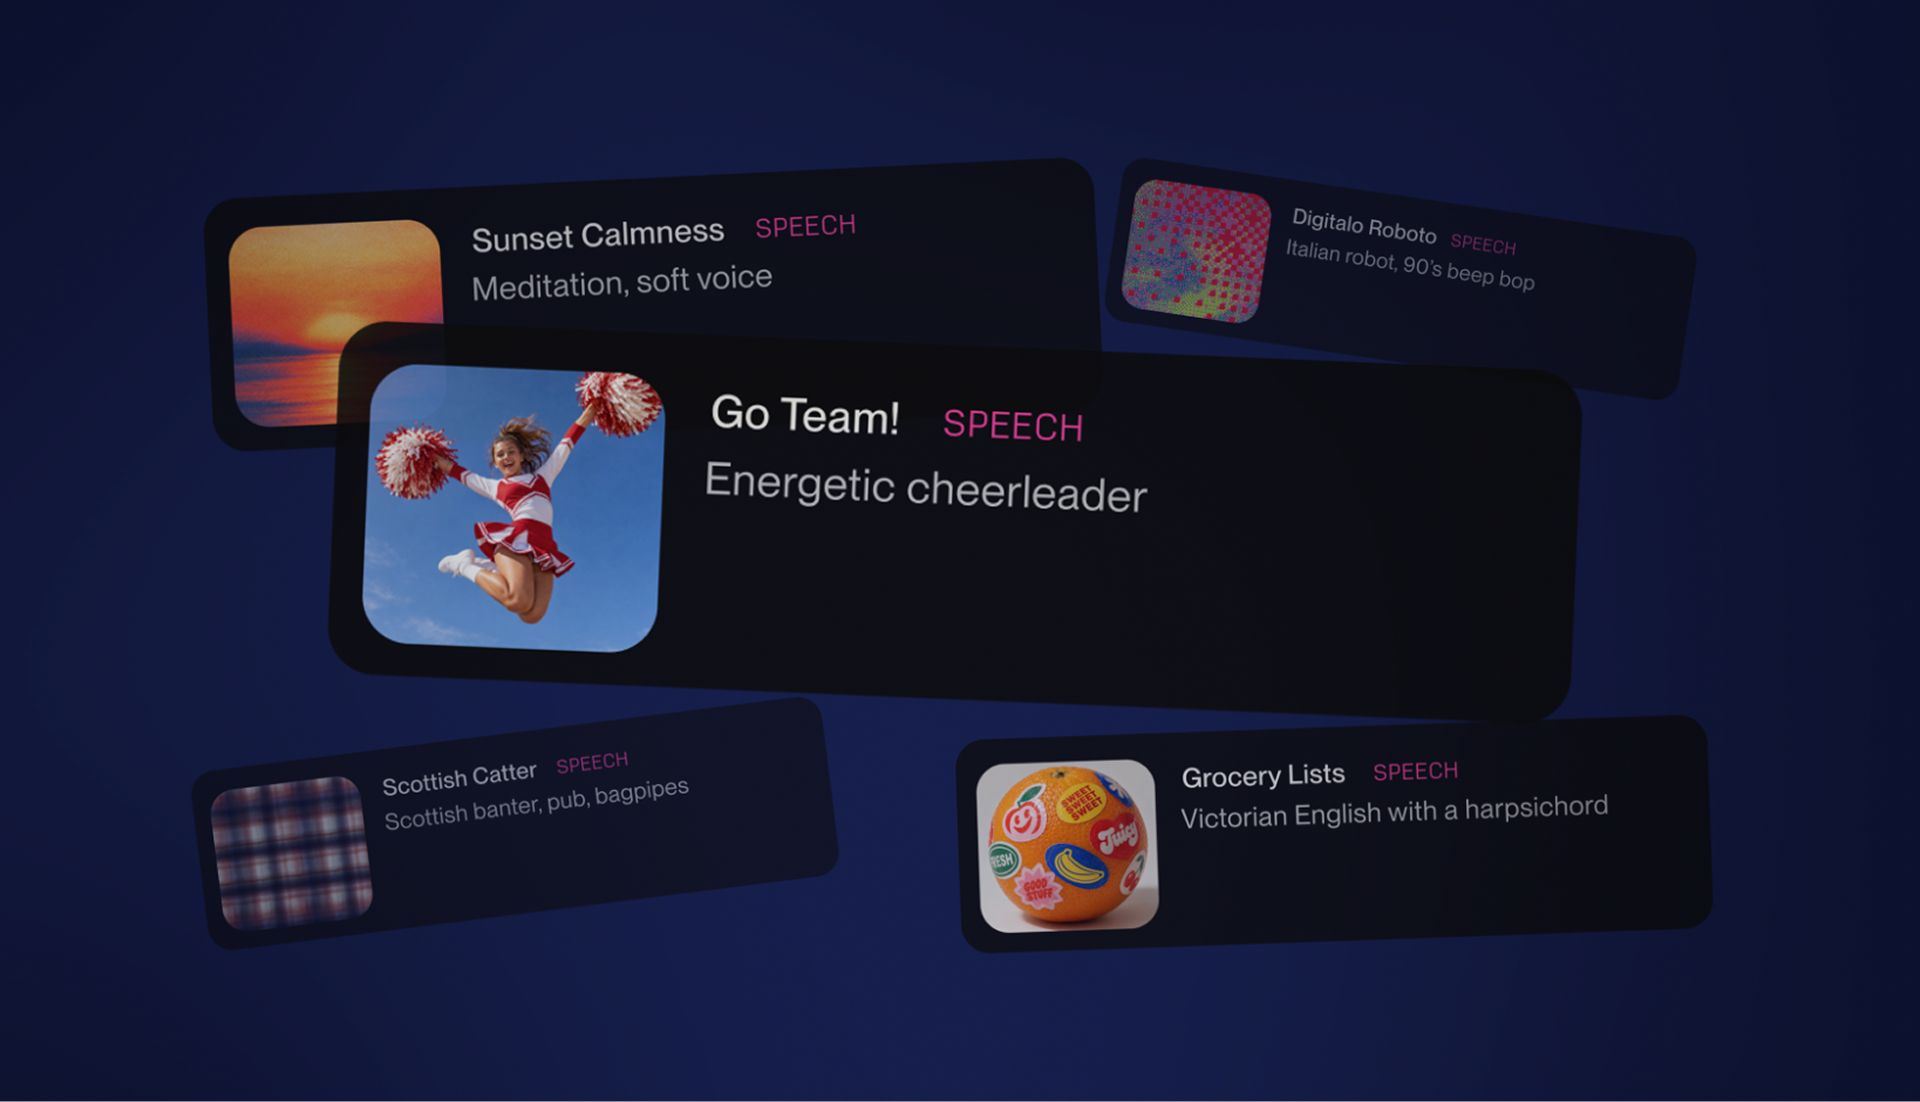
Jack Brodyは発表文でかなり広い線を引いた——Speechは音楽家だけを相手にするのではなく、「アイデアを音にしたい」人に向けた機能だと。Suno社内でのSpeechの試用では、すでにこうしたユースケースが回されていた。友人から来たショートメッセージを劇的な朗読に仕上げたり、ありふれたボイスメッセージに壮大(エピック)なBGMをつけたり、瞑想のガイド、詩、子ども向けの寝かしつけエピソード、誰かを励ます言葉(pep talks)など。こういった用途では人声が主役で、BGMは単なる引き立て役だ。
この方向性はSunoの既存ユーザーの使い方と地続きだ。毎日、誰かが誕生日ソング、結婚式ソング、社内ネタの曲、信仰ソング、子どもや友人へのうた、誰かにとっては無意味でも自分には意味のある瞬間のための曲を作っている。Speechは「人声+BGM」をこのリストに加えた。
同業他社との差はほんの一歩——既存の音声合成(機械にテキストを読ませるツール)は通常、クリーンな人声だけを出力し、BGMはユーザーが自分で重ねる必要があった。Speechはこの二工程を一工程に押し詰める。
検証ポイントを押さえておきたい。非音楽ユーザーが本当に使いに来るかどうか——Sunoがユーザー像やコミュニティデータを公開した際に、「Speechを使う人」と「曲を作る人」の重なり具合を見る。公式エディタに「瞑想/寝かしつけ/広告ナレーション」のようなシーンテンプレートが用意されるかどうか。テンプレートが詳細になるほど、社内の本気度が重い。音声の長さ上限(現在約8分)がいつ緩和されるか。これがポッドキャストやオーディオブックを本気で取りに行くか否かの、確かな指標になる。
ウェブを開いて、一文書いて、どう鳴るか聴いてみる
SunoはSpeechベータをウェブとモバイルに開放した。ログインすれば使える。入口を開き、文を入力し、生成ボタンを押す。
Sunoアカウントにログインし、メイン画面でSpeechを選び、テキストや説明文を入力する。最初の3分もかからず、合う合わないは判断できる。
SimpleとAdvancedどちらのルートも使える。違いは説明文か原稿かだけで、人声とBGMは常に同じ一本のトラックに合成される。
まず短めの原稿で試す。最初から8分一本に張らないこと。
Sunoのウェブ版またはモバイル版にログインし、Speechベータの入口を見つけて、Simpleモードで説明文一文から1本作ってみる(30〜60秒)。
Advancedモードに切り替え、自分の原稿を貼る(まずは1分以内を推奨)。男女の声、異なる話し方を試し、BGMと人声のフィット感を比較する。
発音のクセと、不自然に長く空く間の2点だけを聴き返す。気になる箇所があればスクショで残し、公式アップデート後に同じ原稿で再検証し、直っているか確認する。
実用的な成果を1本作ってみる。第1〜3ステップでいちばん安定していた設定を使い、1〜3分の小さな完成品(ポッドキャストのオープニングや短い読み聞かせなど)を作る。以後の比較基準として手元に残す。
Suno公式ブログのSpeech更新ログをフォローする。ベータ期間は機能が変わる。今日のバグが次バージョンの重点修正項目になることもある。
やっていい範囲ははっきりさせておく。SunoはSpeech用の独立APIについても、サードパーティプラグイン対応についても明言していない。既存のワークフローに組み込みたいなら、まず公式サイトに新しい動きが出ていないか確認すること。
情報源はSuno公式ブログ、署名者はチーフプロダクトオフィサーのJack Brody。基準はベンダーによる自社新機能の紹介であり、ベータ段階の制約はベンダー側が自主的に開示している。