2026 年 10 月 1 日,Suno 上线 Speech 公测版:写一段文字,AI 同时配出带背景音乐的人声,一整条音轨直接出成稿。配音和配乐过去是两步活——先文字转语音出干声,再挑 BGM 手动对位;Suno 把它们塞进同一个模型,一次生成。做播客、有声书、广告旁白,从写稿到出片的距离被压到几分钟。前提是,它自己承认还是 beta。
写一句话,人声和配乐一起出来
Suno 首席产品官 Jack Brody 署名发布 Speech 公测版,网页端和手机端同步开放。此前约一个月,这套能力只在小范围用户里测试。
过去给一段人声铺配乐,得先用文字转语音工具 TTS(文字转语音工具,常见的"机器配音"就是它)生成人声、再手动叠背景音乐。Suno 把这两件事合进同一个模型:人声和配乐作为同一条音轨一次性输出。
Brody 在博文里把话说得很满:这是"the first audio model that generates voice and music together as one cohesive track"——第一个把语音和音乐一起当作一条完整音轨来生成的音频模型。Suno 管这叫 "creative entertainment":让更多人体验"把想法变成东西"的乐趣,音乐只是起点。
两步活怎么折叠成一步?
Suno 的 Speech 不是先合成语音再叠音乐——人声和配乐从输入到输出只走一次,在模型内部就已经对齐。
用户的操作只有三步:在 Suno 里写一段文字——可以是一句创意、一首诗、一段稿子——再点选想要的嗓音和音乐风格,模型就同时把人声和配乐合成输出。语音和配乐在模型内部就已经对齐节奏、情绪、停顿,最后端出来的是一条文件,不是两条等用户手动混。
关键区别在「同一个模型一起生成」。以往做带配乐的人声,常见流程是 TTS(文字转语音,先把稿子读成干声)出一段干声,再去音乐库挑 BGM,最后在剪辑软件里手动对位、压音量、调情绪。Speech 跳过了这套拼接:节拍、人声起伏、背景乐的情绪曲线都由模型一次性安排。
两种输入模式覆盖不同熟练度的用户:Simple 模式只写描述,比如「一个沉稳的男声读一段深夜独白,背景是 lo-fi」,模型自己补全人设和配器;Advanced 模式接受写好的稿子,让用户更精细地控制 voice gender、speech style、voice variety 这些参数。生成上限约 8 分钟,刚好覆盖一集短播客或一段产品旁白。
口径:Suno 官方产品说明
口径:Suno 官方(Brody 署名文)
口径:第三方报道引用 Suno,未见独立复测
传统 TTS 工具输出的是干人声,配乐另算;剪映、Suno 此前的工作流是「先生成音乐,再叠旁白」。Speech 把这两步折叠成一步,代价是用户在配乐细节上的手动控制权变弱——但对播客、有声书、广告旁白这种「脚本固定、配乐服务于内容」的场景,从写稿到出片的距离被压到几分钟。
英音会漂到澳洲,「非常」戏剧的停顿真会出现
beta 真的还是 beta。Suno 的 CPO 主动在博客里写下两个翻车点:英式口音会跑偏到澳洲口音,戏剧性停顿可能「非常」戏剧性。
新模型上线,厂商一般先发通告,再补一封「已知问题」邮件。Suno 把两件事压进同一段:'And beta really does mean beta.' 紧接着承认英国腔会晃到澳洲腔,又自嘲戏剧化停顿 'may be very dramatic'。把「产品还在路上」写进发布稿,这件事本身就少见。
英式口音漂移属于口音稳定性问题——人声合成(text-to-speech)TTS(把文字转成自然人声的技术)里的常见翻车点,通常是训练数据里某类口音样本不够。Suno 没有解释原因,只在博客里如实告诉用户「会跑」。'very' 的斜体加重是 Brody 故意写的,用语气词提醒你:暂停可能长到让人误以为音频卡死。
对比之下,Sora、ElevenLabs 上线时都先做能力展示、再做免责声明。Suno 反过来——先交底缺陷,再请你玩。这种倒序值得停下来看:它在重新划 beta 的门槛。
冥想、睡前故事、加油喊话:Suno 想接的不只是音乐
冥想、睡前故事、加油喊话、诗朗诵——都不是音乐,但都需要声音。
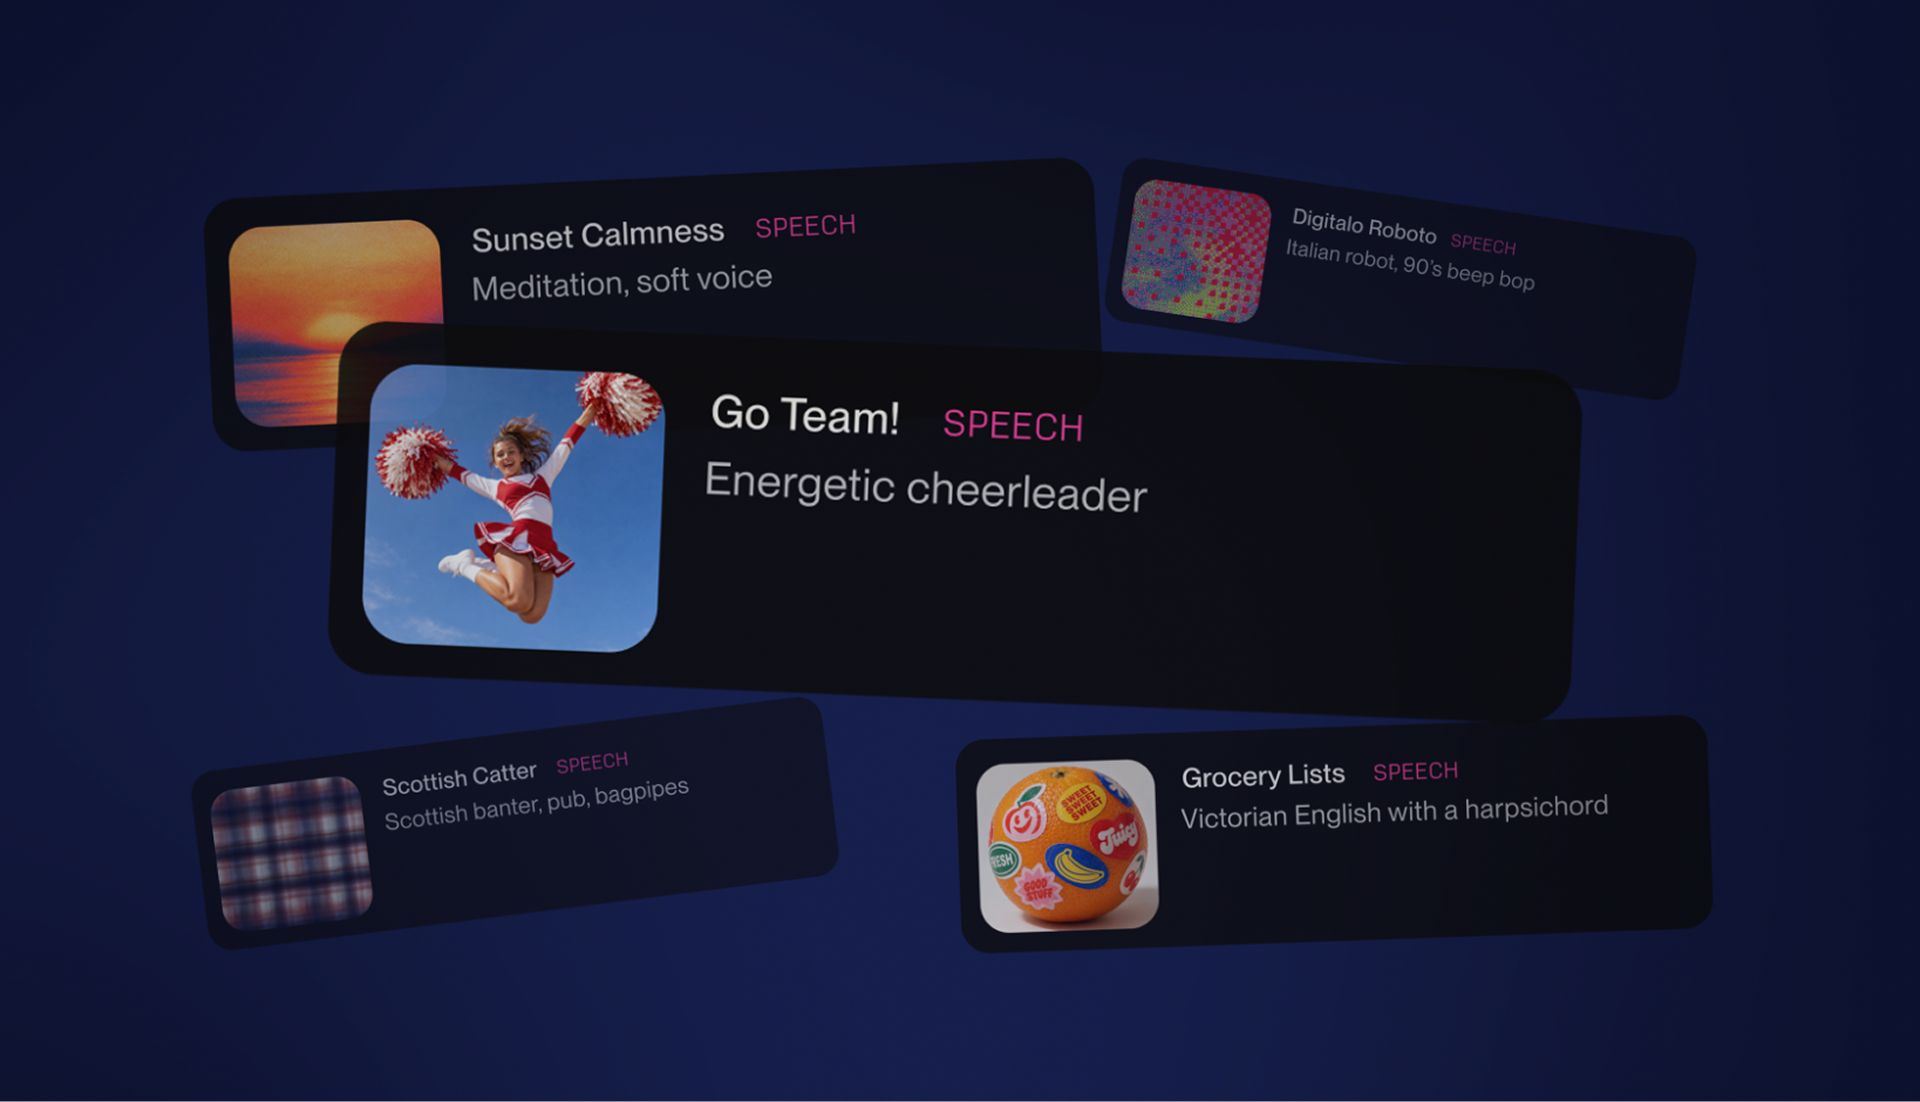
Jack Brody 在发布稿里划了一条很宽的线:Speech 不只服务音乐人,也给「想把一个想法变成声音」的人。Suno 内部试 Speech 时就把这些用法跑了一遍——把朋友发来的短信做成戏剧感拉满的朗读,给普通语音条配上史诗配乐,再做冥想引导、诗歌、给孩子听的睡前故事、给人打气的喊话(pep talks)。在这些用法里,人声是主角,背景音乐只是托。
这条线接得上 Suno 现有用户的行为:每天有人用它做生日歌、婚礼歌、内部梗、信仰歌曲、给孩子和朋友的歌,以及那些对别人毫无意义、对自己却意义重大的时刻。Speech 是把「人声 + 配乐」也加进了这个清单。
对照同行,差别只有一步:现有语音合成(让机器读出文字的工具)通常只出干净的人声,要配乐得自己再叠,Speech 把这两步压成一步。
盯几个可验证的点:非音乐人是否真的来用——Suno 公开用户画像或社区数据时,留意「做 Speech 的人」和「做歌的人」重叠度是高是低;官方是否在编辑器里给出「冥想/睡前故事/广告旁白」这类场景模板,模板越细说明内部押注越重;语音时长上限(现约 8 分钟)何时放开,这是它是否真想啃播客、有声书的硬指标。
打开网页,写一句话,听听它怎么说
Suno 把 Speech beta 放到了网页和手机端,登录就能用。打开入口,输入一句话,按下生成。
登录 Suno 账户,在主界面选择 Speech,输入一段文字或一句描述。前 3 分钟就能判断它适不适合你。
Simple 和 Advanced 两条路径都能用,区别只在描述还是贴稿,人声和背景音乐始终合成同一条音轨。
先短稿试水,别一上来就压 8 分钟的活。
登录 Suno 网页或手机端,找到 Speech beta 入口,先进 Simple 模式用一句描述跑一版(30~60 秒)。
切到 Advanced 模式,贴一段自己的稿子(建议先 1 分钟内),分别试男女声、不同说话风格,对比背景音乐和人声的贴合度。
盯紧一个质量信号:口音是否漂移、停顿是否过头。如果有,标出时间点截图,等官方更新后复测同一段稿子,看是否修正。
压一个实际用途:把第 1~3 步里最稳的设置做成一条 1~3 分钟的小成品,比如播客片头或一段睡前故事,存下来作为后续对比的基准。
关注 Suno 官方博客的 Speech 更新日志,beta 期间功能会变,今天的 bug 可能是下个版本的重点修复项。
动手的边界要清楚:Suno 没说 Speech 有独立 API,也没说支持第三方插件调用,想把它嵌进现有工作流,先确认官网有没有新动作。
信源为 Suno 官方博客,署名人为首席产品官 Jack Brody,口径为厂商对自家新功能的介绍,beta 阶段的局限由厂商主动披露。