AIコーディングツールが「コードを書く」行為をほぼゼロコストにしたが、すべてのPRは依然としてCIを完走する必要がある。Linear社のエンジニアリングチームは、自社のテストスイートが年初から4倍に膨れ上がり、PRの待機時間が一時6分以上にまで押し上げられたことを発見した。彼らは4つの施策でこのパイプラインを作り直し、サードパーティのrunnerへの変更、変動検知ゲートの圧縮、重複する起動コストの削減、ネイティブコンパイラへの置き換えによって、PRの待機時間を約5分まで短縮した。
AIによるコーディングは無料化したが、CIが新しい行列の窓口になった
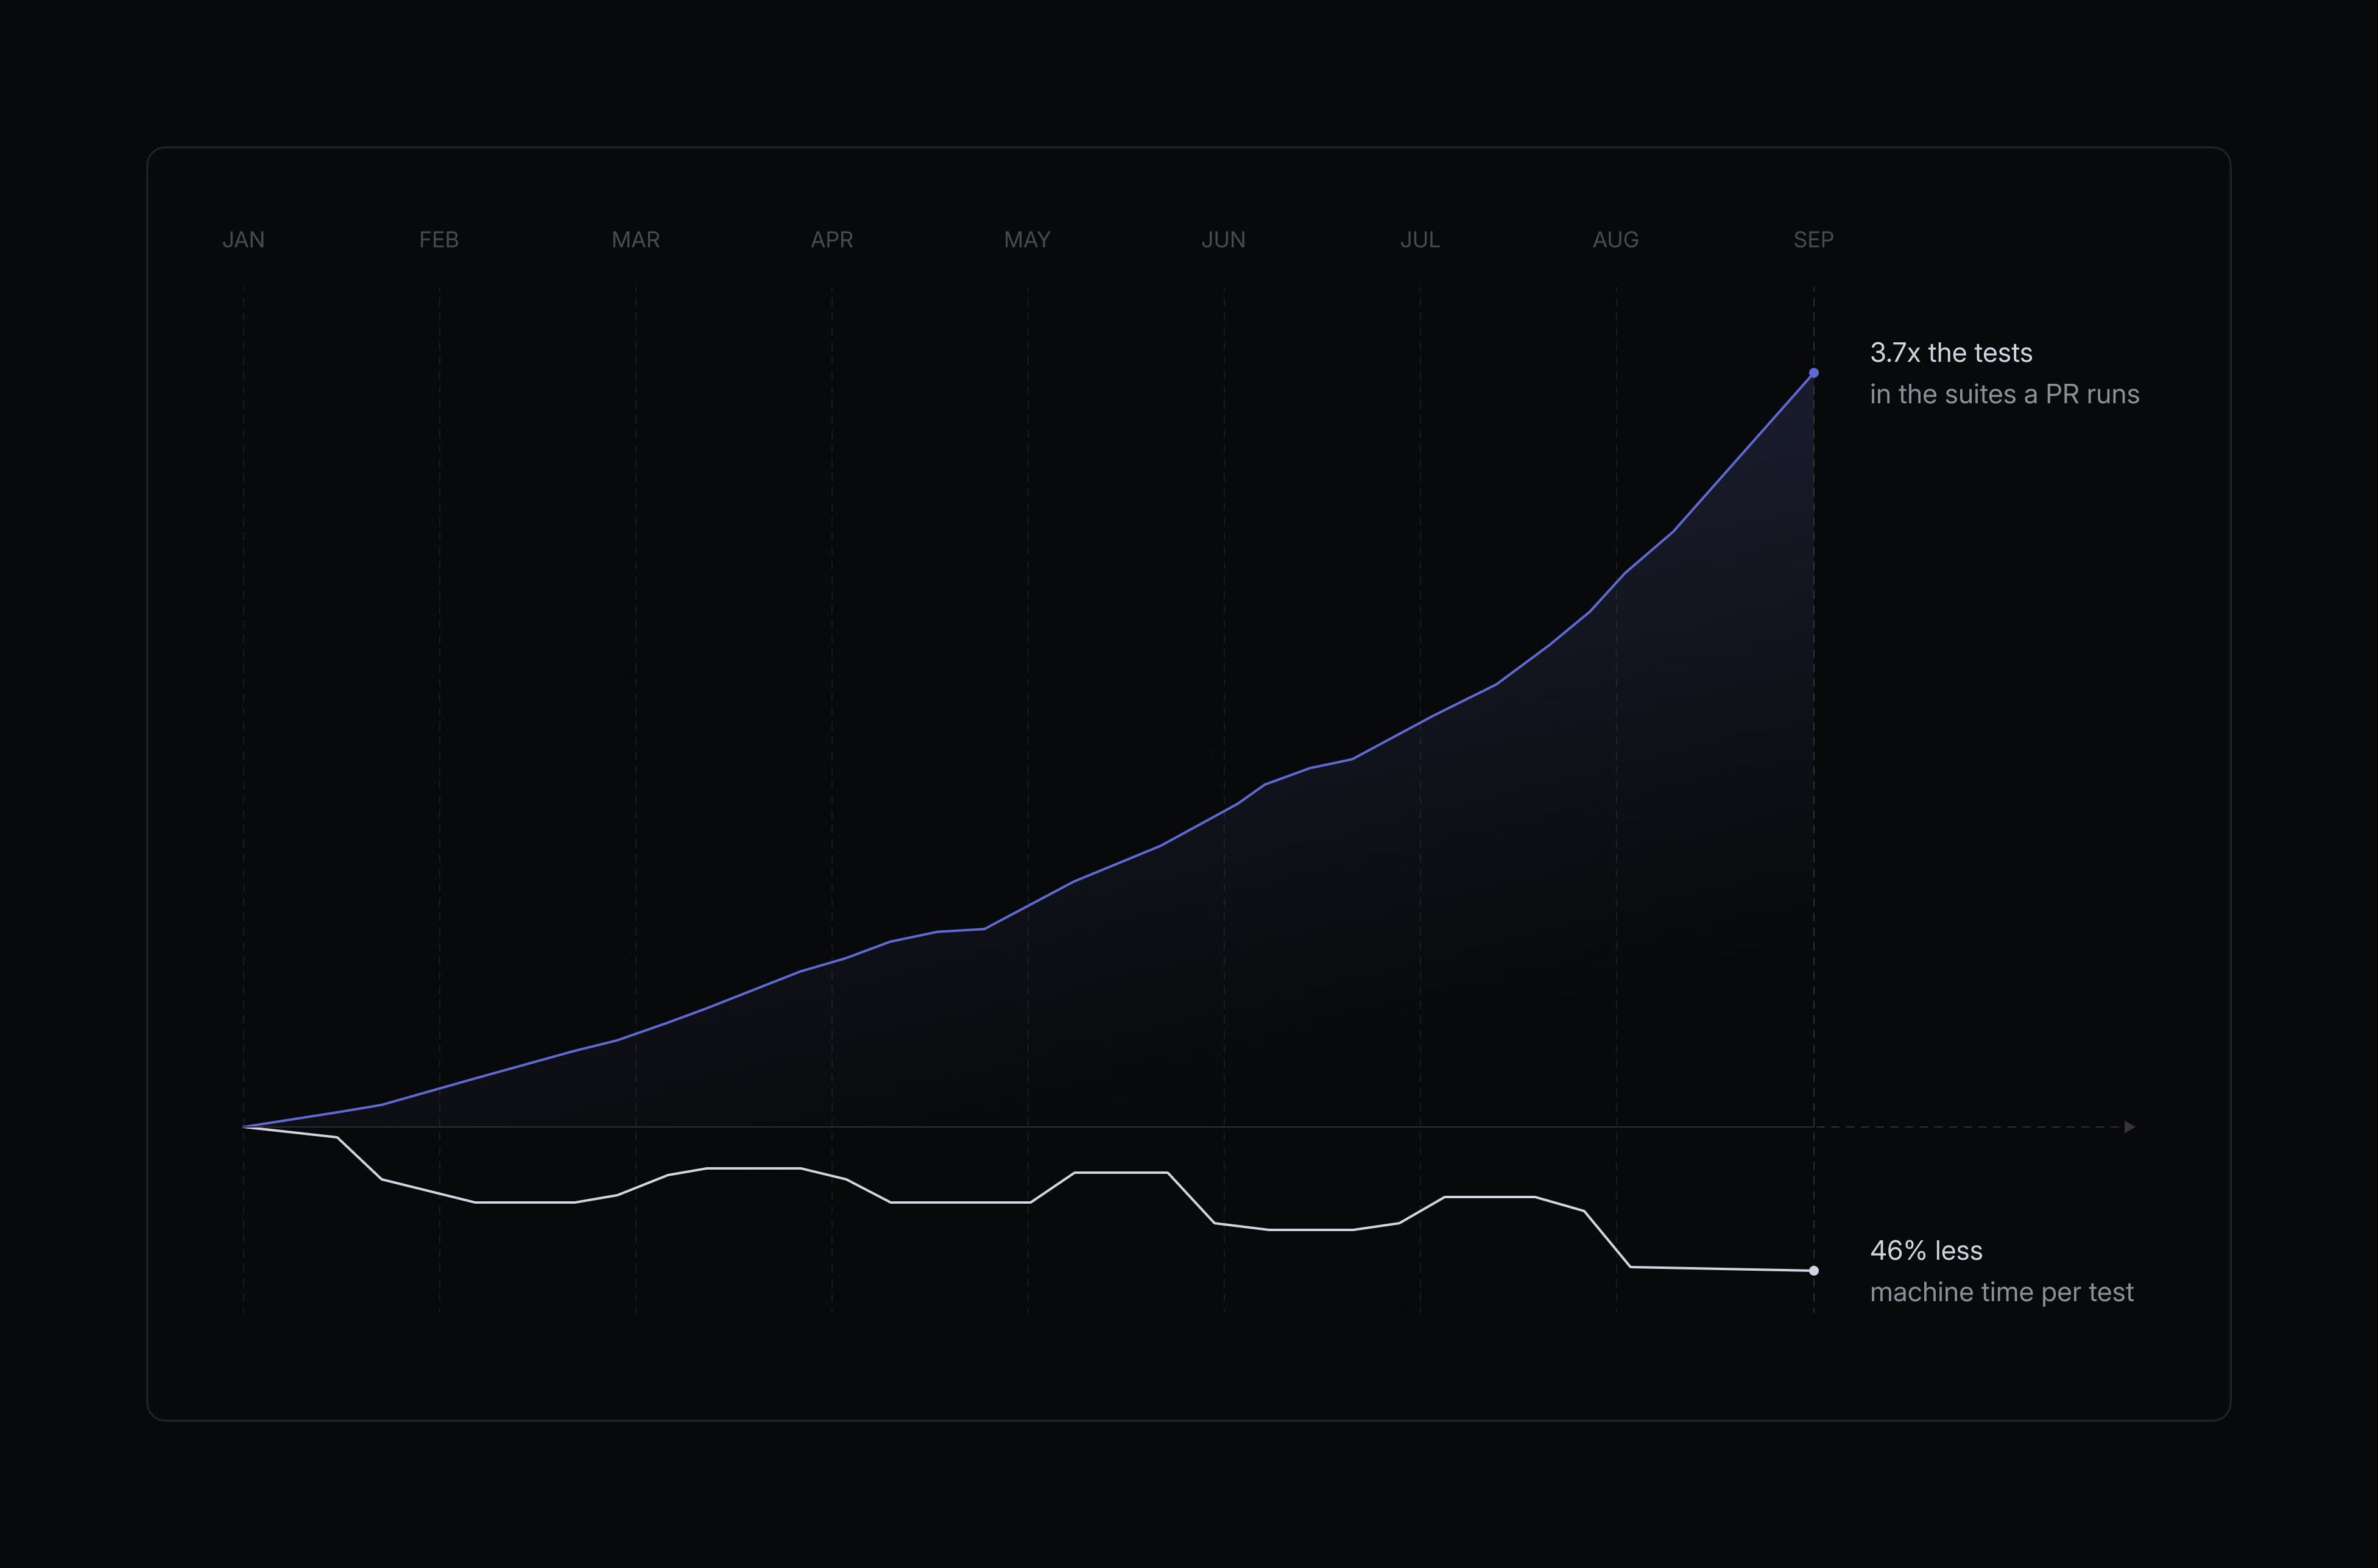
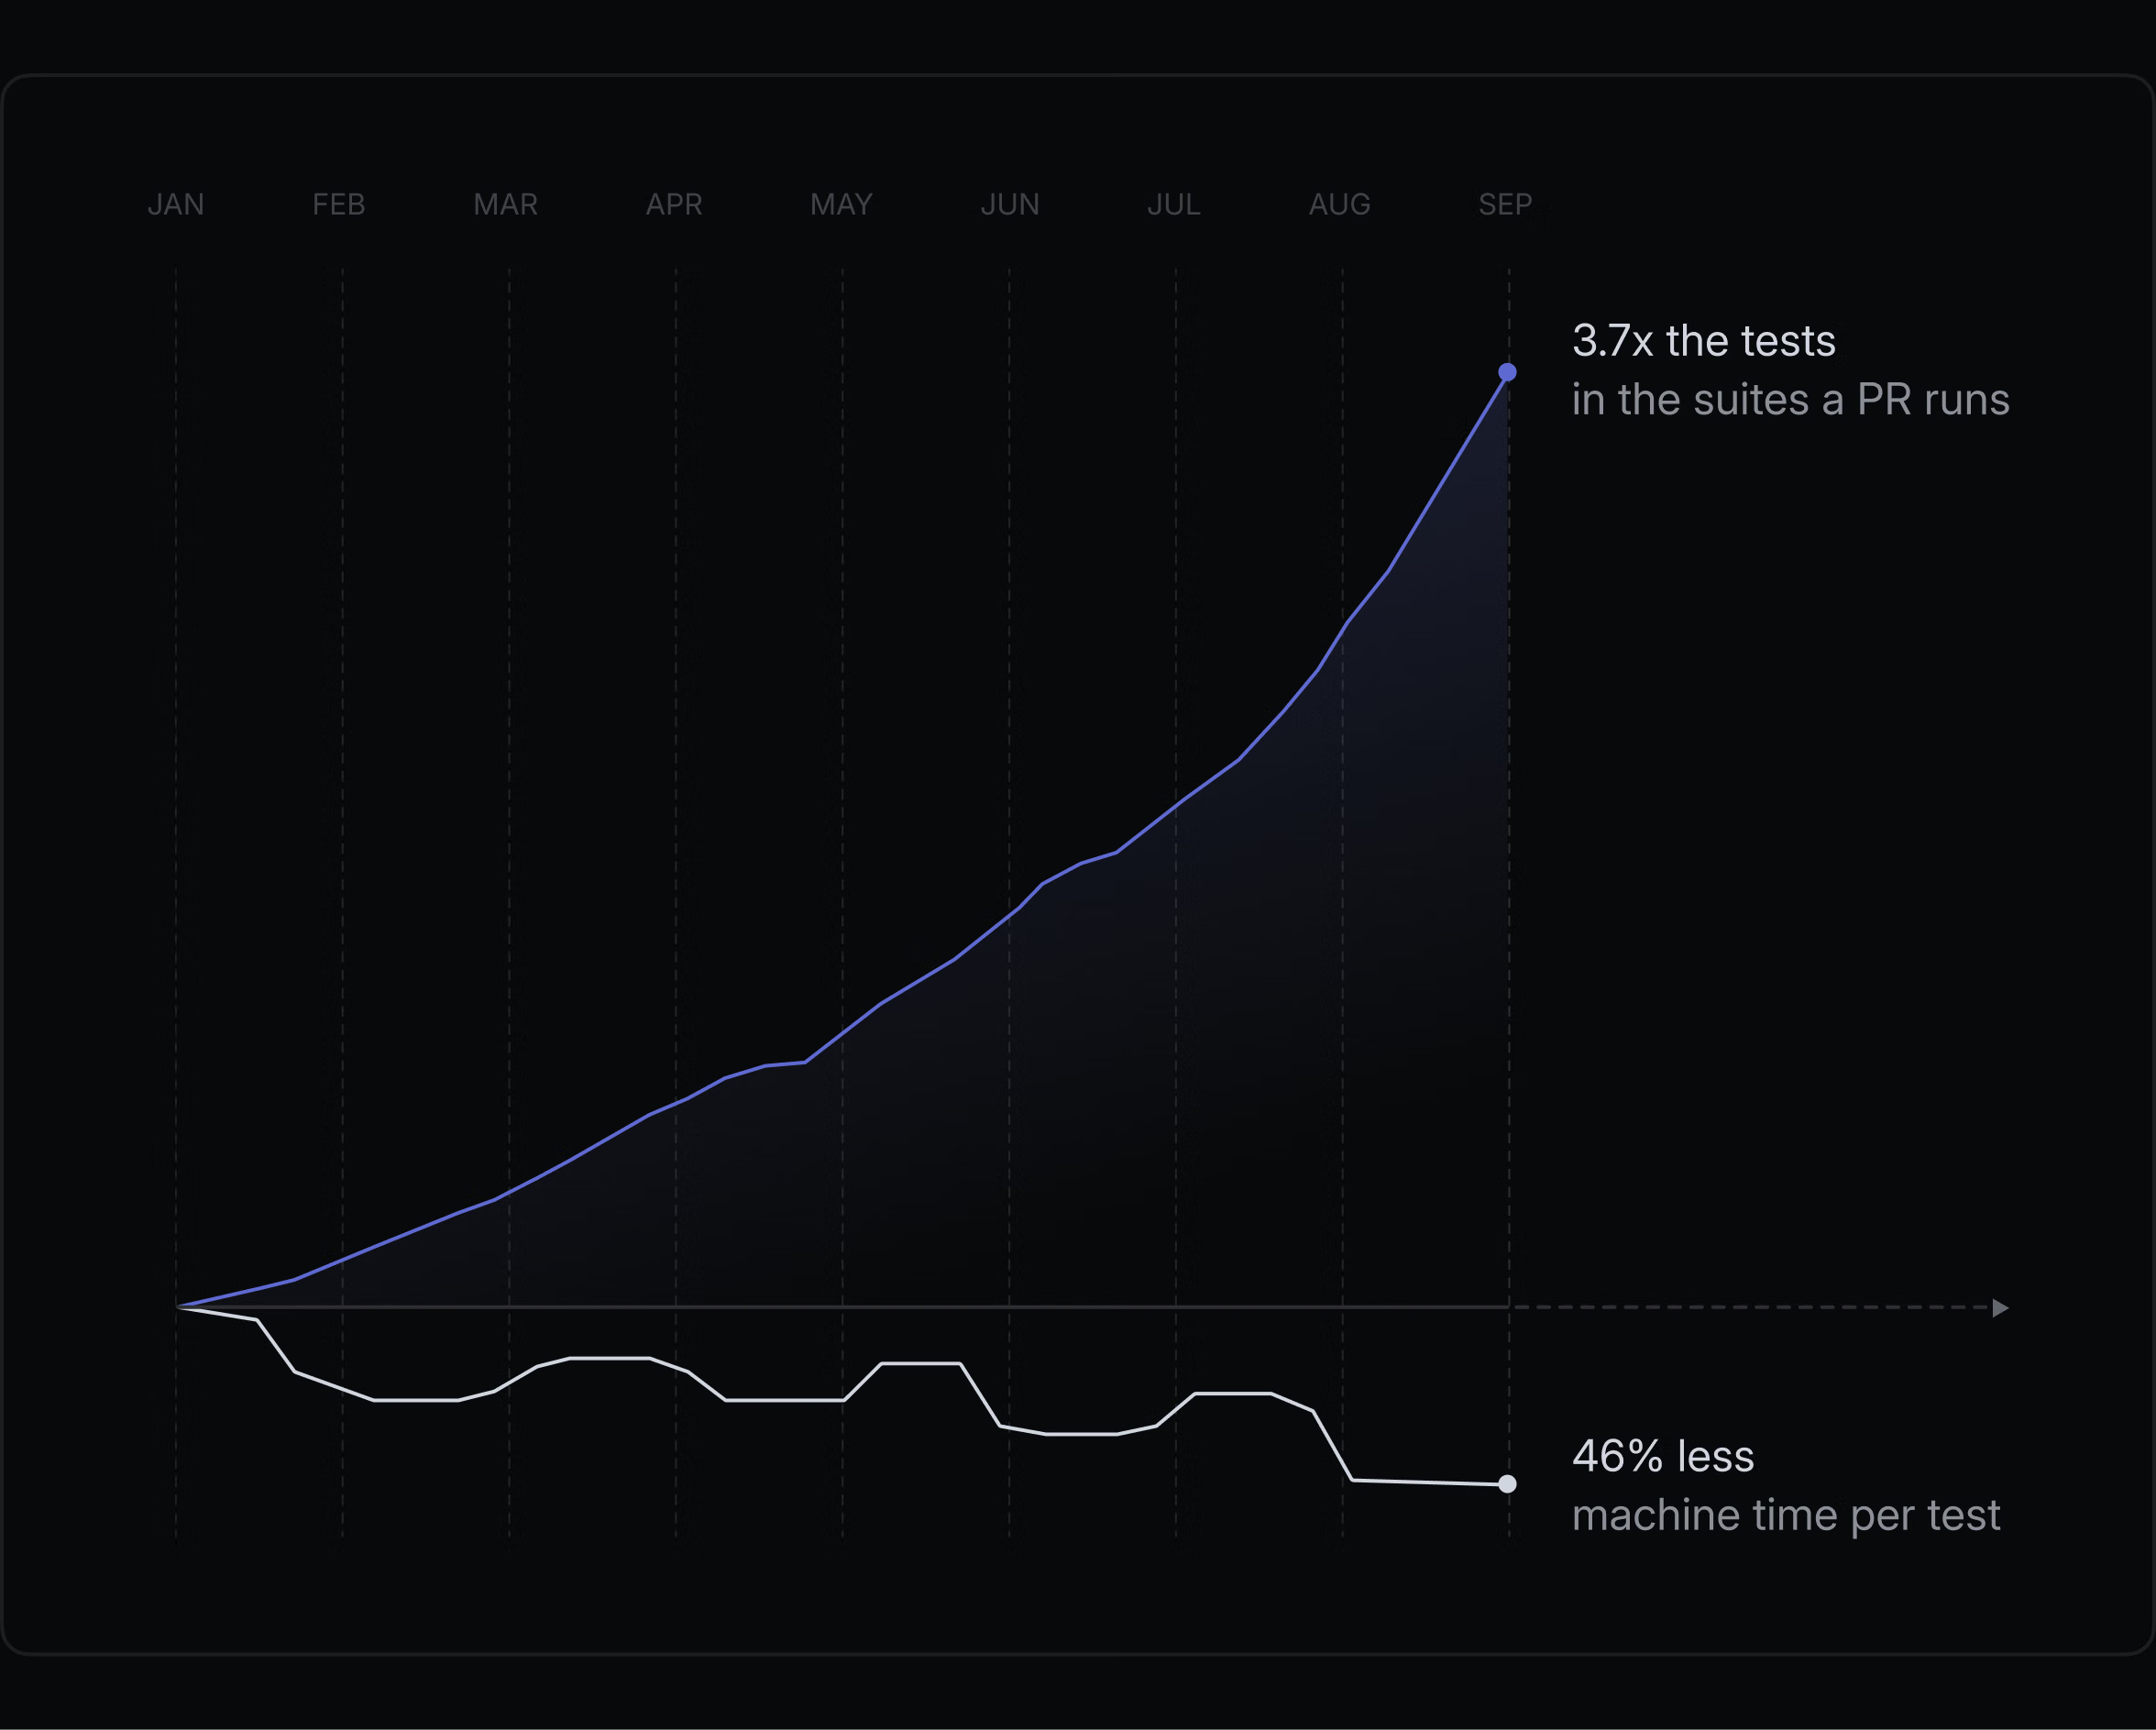
Linearのテストスイートは年初からほぼ4倍に膨れたが、PRのCI待機時間は逆に短縮された。
コードを書く速度は上がったのに、なぜPRは遅くなったのか?それは各PRが依然としてCI(継続的インテグレーション。コミット後に自動でテスト、コンパイル、ビルドなどのチェックを実行するパイプライン)を完走する必要があるからだ。エージェントが「コードを生み出す」工程のコストをほぼゼロまで引き下げた一方、「検証する」工程が追いつかず、キューがCIの上に積み上がった。
今年初頭、LinearのエンジニアMufeez Amjadがボードを開くと、CTOのTuomasから1枚のチケットが飛んできた。タイトルは「CIのコストが高すぎる」の一言。そして末尾に「できればもっと速く」も添えられていた。
彼らが注視していたのは2つの指標だった。PR(Pull Request。開発者がメインブランチに変更を提出し、マージを要請する仕組み)がCIで待つ時間、そしてそれが消費するrunner時間。テスト量は倍々に増えていくのに、この2つの数値は逆に下げる必要がある。どうやって4種類の施策で実現したか、以下で分解する。
マシンを替え、コンパイラを替える——単一で最遅の処理から先に潰す
3種類の施策はすべてパイプライン構造の外側にある。より高速なrunnerへの移行、ネイティブコンパイラへの置換、TypeScriptの型情報からのlint分離だ。それぞれが時間を短縮するロジックは異なる。
Linearの最初の一手はマシンそのものだった。ワークロードをGitHub Actionsからサードパーティのrunnerへ移行した。CPUが高速で、ストレージが安定し、キャッシュが信頼できる。コードも設定もそのまま、同じパイプラインをより高速なハードウェアに乗せ替えたことで、単体で最も遅い一群のタスクが先に短縮された。
2番目の一手はコンパイラだ。Linearはほぼ全面TypeScriptで、tsc(TypeScript公式コンパイラ。ファイル単位で型チェックを行う)は毎週ボトルネックになっていた。tsgo(TypeScriptネイティブコンパイラ。Goで書き直され、起動と単一パスのチェックが高速)は道理が単純で、型チェック自体がCPU負荷の高い処理であり、コンパイル型言語で書き直せば単一パスの固定オーバーヘッドが下がる。型チェックがボトルネックでなくなり、パイプライン全体の待機重心もそれに伴い移動した。
3番目の一手はlintだ。Linearの独自ルールの一部はTypeScriptの型情報に依存していた。型情報を利用した制限を行ったり、autofix(エディタやツールがルールに従ってコードを自動修正する)を実現している。lintを1回走らせるたびに毎回フルスケールで型グラフを構築する必要があり、lintはCIで最もメモリを消費するジョブの1つになっていた。型グラフ構築というステップが、遅さの根本原因だった。
チームはこの一連のルールを、抽象構文木(AST。コードを関数・if・returnといった最小構文要素の木構造に分解したもの)への静的解析に書き換え、型情報を経由しないようにした。ESLintはTypeScript依存から完全に切り離され、メモリ使用量もそれに伴って下がった。
副次的な利点として、その後のOxlint(Rustで書かれた超高速linter。構文層のルールに集中)への移行が非常に楽になった。構文のみを対象とするルールはそのまま移植でき、型との結合を処理する必要がない。Oxlintが稼働した後、lintのrunner-minutes(CIマシンの分単位課金合計時間)はさらに下がった。
8つのシャードを止めているのはテストではなく、前段の26秒の小門だった
8つのシャードを止めていたのはテストではなく、前段の26秒の小門だった。マシンとコンパイラを替えても、パイプライン全体の待ちは別の場所に残っていた。Linearが視点を単体ジョブからパイプライン全体に引き上げた時、ボトルネックが全員の前にある変動検知ジョブに潜んでいることが判明した。
各パイプラインの先頭には変動検知ジョブがある。PRがどのパスを変更したか、データベース関連のチェックを走らせるべきかを判定する。8つのAPIテストシャード(テストを複数に分割し並列実行する単位)はすべてこのジョブのシグナルを待っており、1秒詰まれば後続の8シャードすべてが1秒遅れる。
ところがこのジョブ自身は無駄なことをずっと続けていた。1〜2ファイルの変更だけが必要な場合でも、作業ツリー(コード全体の完全なコピー)全体を毎回取得していたのだ。中央値26秒、最悪時は94秒もかかった。判定しかしない小さな門が、通そうとしているどのテストよりも遅い。
Linearが行った1つ目は、fetchにdepth上限(取得する履歴の深さを制限)を設定し、最悪値を94秒から20秒に縮めたこと。2つ目は、そもそもcheckout自体を除去した。一部のゲート用ジョブは作業ツリーをそもそも必要としないため、27秒から7秒に落ちた。3つ目は、diff(コード差分の比較)パスを本当に必要とするフローに対してsparse checkout(必要なディレクトリのみ取得)に切り替え、さらに11秒強を削減した。
マシンの変更、コンパイラの置換といった単体最適化を済ませた後、Linearは視線を上げ、CIを1つのシステム全体として捉えた。クリティカルパス(遅延するとパイプライン全体が待つ区間)上では、前節で触れたtsc・lint・testがそれぞれ高速化された。しかしさらに目立たない門がある。キャッシュマーカーの書き込み位置だ。Linearは元々、cacheマーカーを「マージ前最後のチェック」の中に書いていたため、テストがすべて通っても、PRはこの書き込み動作をマージキュー内でただ待つことになった。ゲートではないジョブに書き込みを移したことで、マージ経路から42秒が消えた。
ゲートジョブを優先的に手を入れる価値があるのは、それが本当にクリティカルパス上にいる場合に限られる。一度クリティカルパスから外れれば、それ以上削っても意味はない。
node_modulesキャッシュの廃止:時にはキャッシュしない方が速い
キャッシュできるものはすべてキャッシュする——その本能がnode_modulesでは裏目に出た。Linearが一通り試したところ、キャッシュヒットの方が再インストールより遅く、思い切ってキャッシュを廃止した。
判断は単純だった。node_modulesのキャッシュヒット率・所要時間と、依存関係を再インストールする時間を並べて比較した。キャッシュヒットでも28秒かかり、キャッシュせずに直接インストールするとわずか7.5秒だった。差が大きすぎ、キャッシュの存在理由がない。廃止した。
これはより大きなトレンドを示している。AIコーディングによりコード変更が密になり、CIのボトルネックは「実行時間の長さ」から「起動の遅さ・重複の多さ」へ移った。PRパイプライン開始のたびに毎回、依存を取得し、コードをクローンし、データベースに接続する。これらのオーバーヘッドは固定的で、今回の変更が1行であろうと1ファイルであろうと変わらない。
前節で触れたPostgresクライアントの基本イメージへのプリインストール、APIパッケージの必要な依存のみへの絞り込み、node_modulesのキャッシュ廃止は、いずれもこの固定オーバーヘッドを圧縮する取り組みだ。
今まさにCIを構築・改修している人にとって、より直接的に使える観察点はこうだ。自分の環境で「キャッシュヒット時の所要時間」と「キャッシュなしで直接インストールした時の所要時間」を実測してみる。ヒットが28秒、再インストールが7.5秒——ヒットの方が遅いなら、キャッシュは解体すべきだ。node_modulesのような依存ツリーが膨大で、展開と検証自体に時間がかかるものでは、再インストールの固定コストの方がキャッシュヒットのIOコストより低くなり得る。「キャッシュは常に良い」という経験則は、ここでは当てはまらない。
そのまま真似できるのは2つだけ、残りは理解から始まる
Linearの施策は自社パイプライン固有のものが多く、明日そのまま持って帰れるのは2つだ。
まず直接手を動かせる2点から。APIワークフロー内のpnpm installは、従来44〜73秒かかっていた。インストール対象をAPIパッケージとその依存に絞り込んだところ、16〜18秒に圧縮された。ジョブ単位の変更で、ハードルは低い。
もう1点はPostgresクライアント。各シャード(テストシャード)がかつて7〜8秒かけてaptでインストールしていた。CIの基本イメージに組み込んだことで、このオーバーヘッドは消滅した。どちらもLinear自身がsetup工程を棚卸しした上で見出したものだ。
残るいくつかの施策はよりシステム寄りで、模倣するには熟慮が必要だ。サードパーティのrunnerへの移行で34%の高速化を得られたのは、GitHub Actionsがすでにボトルネックになっていることが前提。現状がそうでなければ、移行のうま味は薄い。
tsgo(TypeScriptコンパイラのネイティブ版)への切り替えのようなツールチェーンの刷新はより急進的で、コンパイラのバージョン変化へのチームの許容度が問われる。cacheマーカーをマージ前ジョブから非ゲートジョブへ移す——こうしたアーキテクチャ調整では、まず自分のクリティカルパスで何が詰まっているかを把握したい。Linearはこの操作でマージ経路から42秒を削ったが、これは同社パイプライン構造特有の結果だ。
自分のPRのCI待機時間の中央値とp90を計測し、「どこに詰まっているか」を数字で固定する。その上で、どのジョブに手を入れるかを決める。
APIワークフローやバックエンドワークフローで依存をインストールする工程を探す。「全量インストール」「絞り込みインストール」「キャッシュヒット」の3経路の実時間を比較し、Linearがnode_modulesキャッシュを廃止した判断ロジックを参考にする。
各シャードがaptでインストールするランタイム(Postgresクライアント、データベースドライバなど)を基本イメージに組み込む。シャードごとの数秒の繰り返しインストールを省く。
クリティカルパス上に「これが終わらないと次に進めない」という小さなジョブがないか確認する。タイムアウトとリトライを設定し、1回の詰まりがパイプライン全体を遅らせないようにする。
runnerの切り替え、コンパイラの置換、cacheマーカーの移動などシステムレベルの施策は、まずクリティカルでない1本のワークフローで2日間A/Bテストする。medianとp90を比較した上で判断する。
出典:Linear Blog『AI coding has made CI a bottleneck, so we reworked ours to keep up』(2026-09-21);基準に関する注記:データはLinear社のエンジニアリングチームが自社CIパイプラインを自ら棚卸ししたもので、ベンダーによる内部最適化の自己報告であり、他チームやツールチェーンとの横並び比較を構成するものではない。