AI 编码工具把「写代码」变成几乎零成本的动作,但每一条 PR 依然要跑完 CI——Linear 工程团队发现自家测试套件年内膨胀到原来的 4 倍,PR 等待时间一度被推到 6 分钟以上。他们用 4 招把这条流水线重做了一遍:换第三方 runner、压缩变化检测门、砍掉重复启动开销、换原生编译器,PR 等待时间压回 5 分钟左右。
AI 写码免费了,CI 成了新的排队窗口
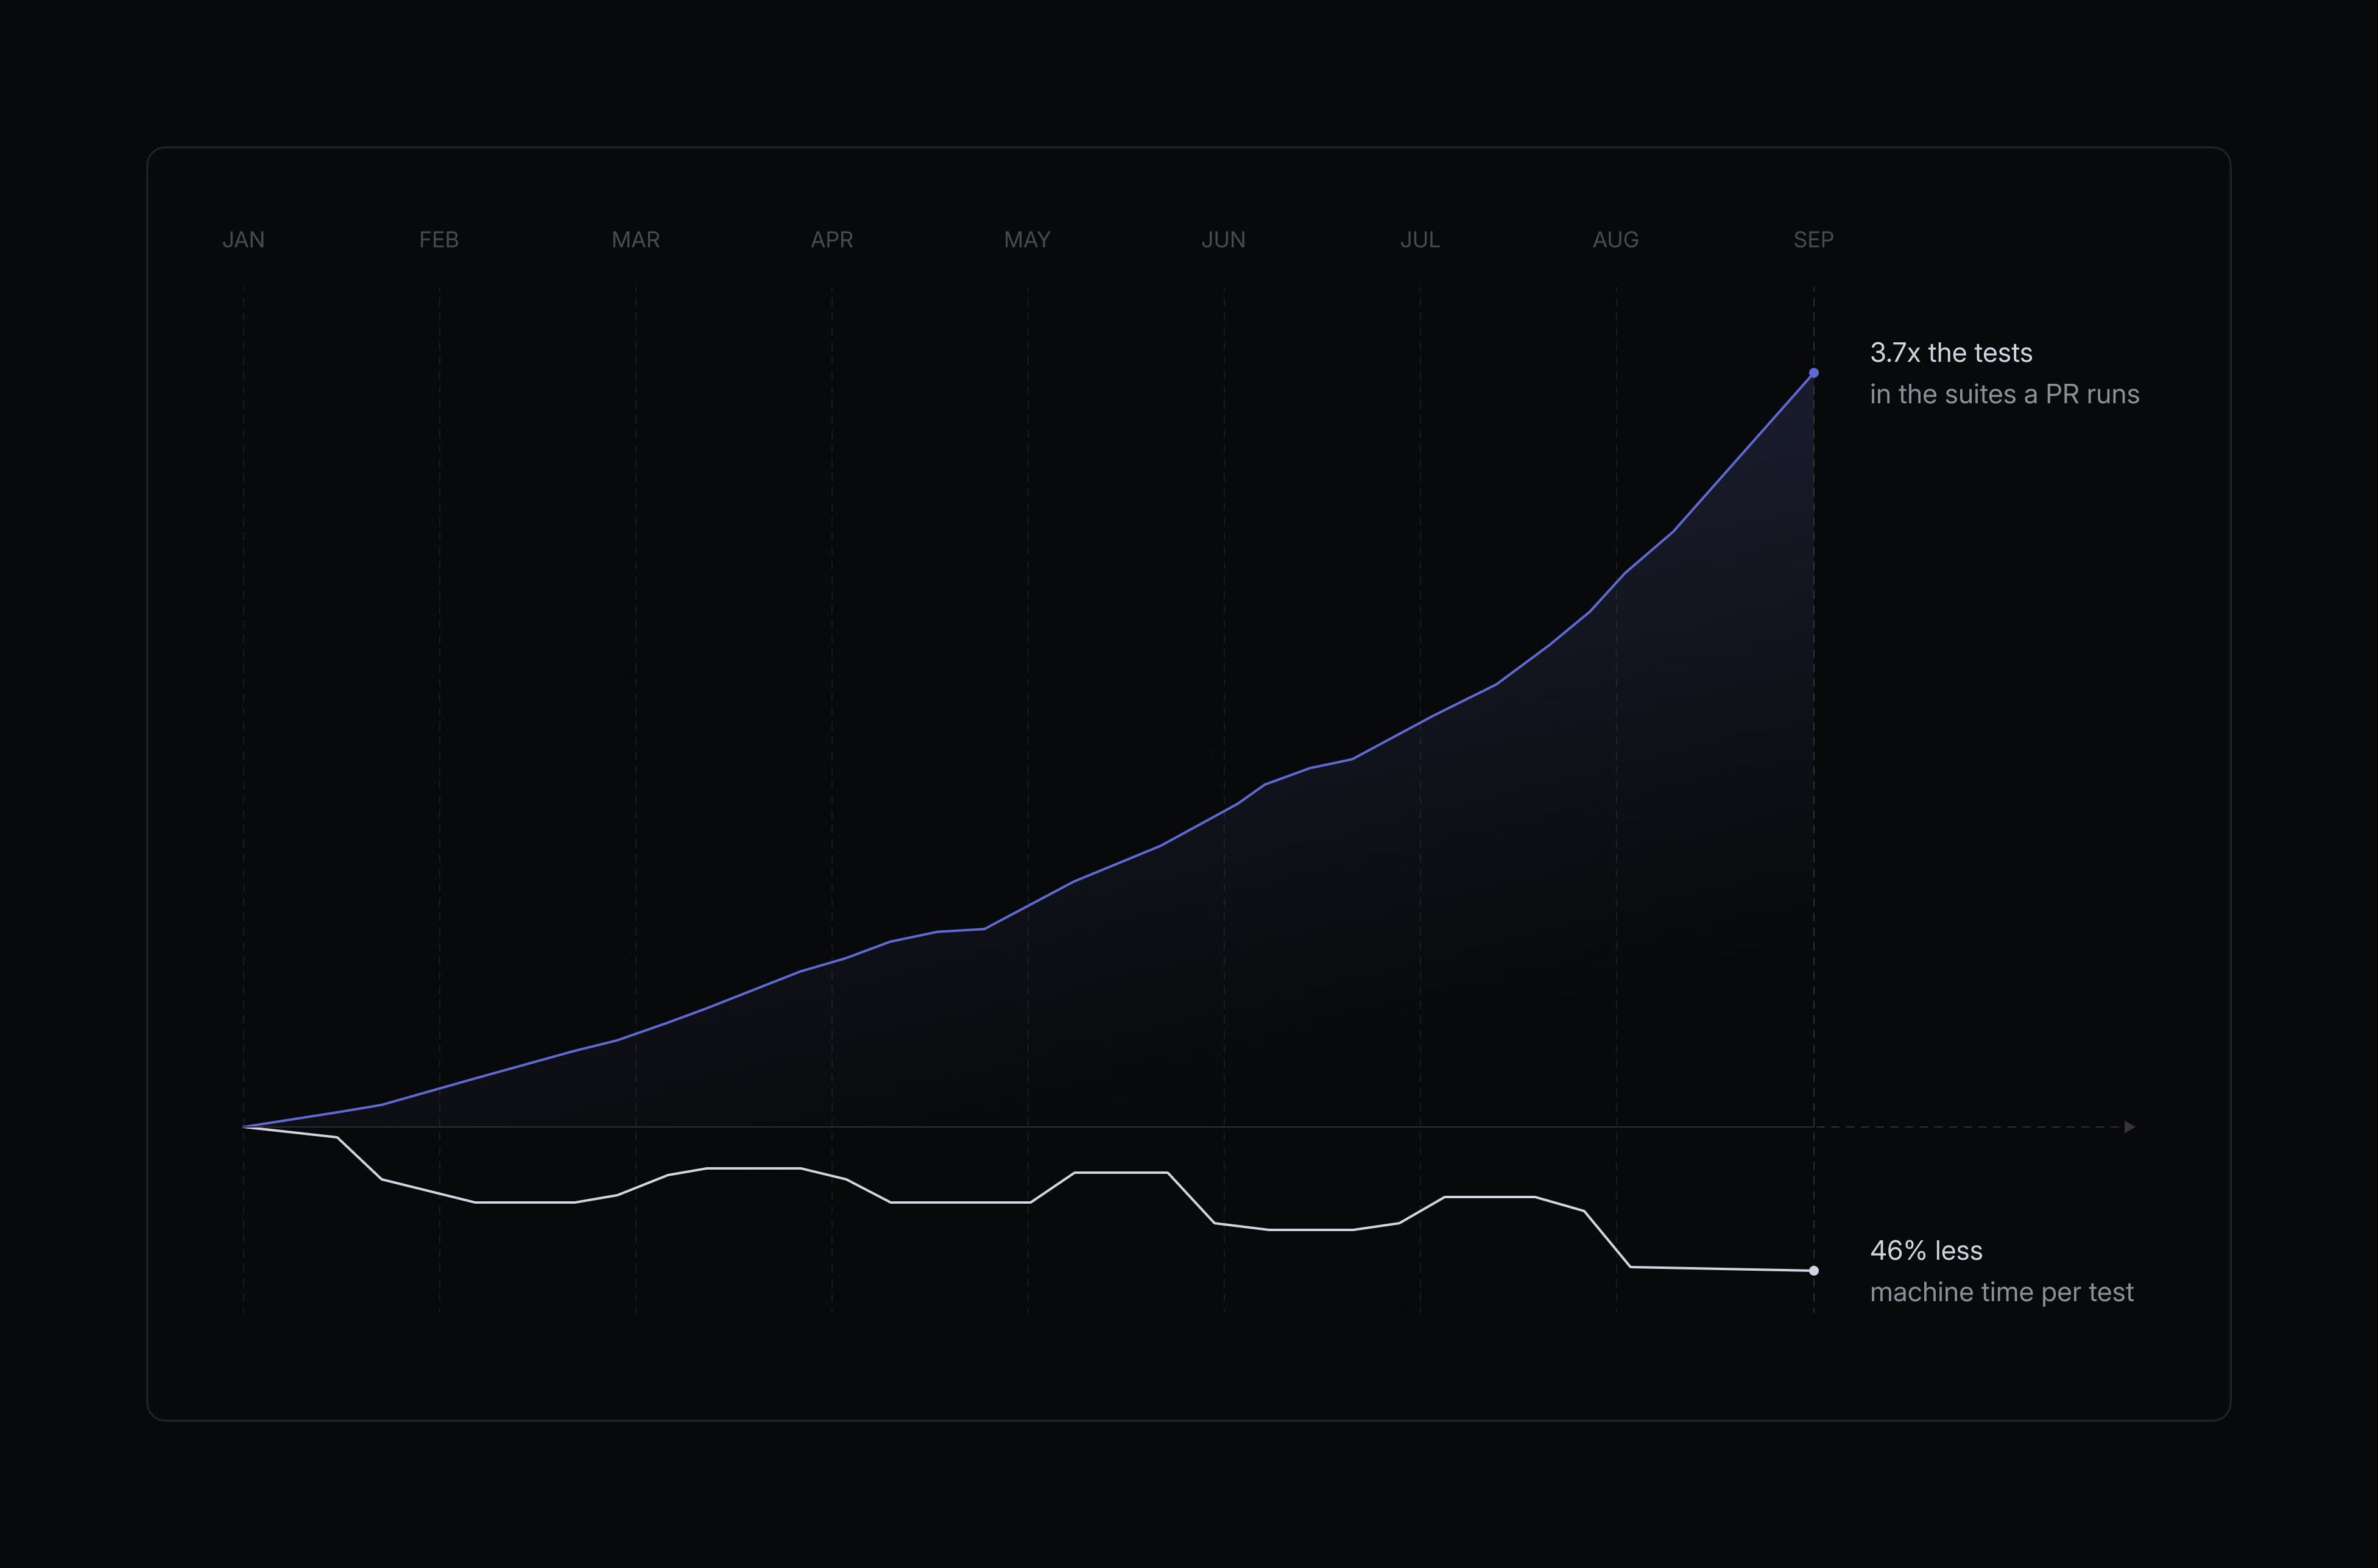
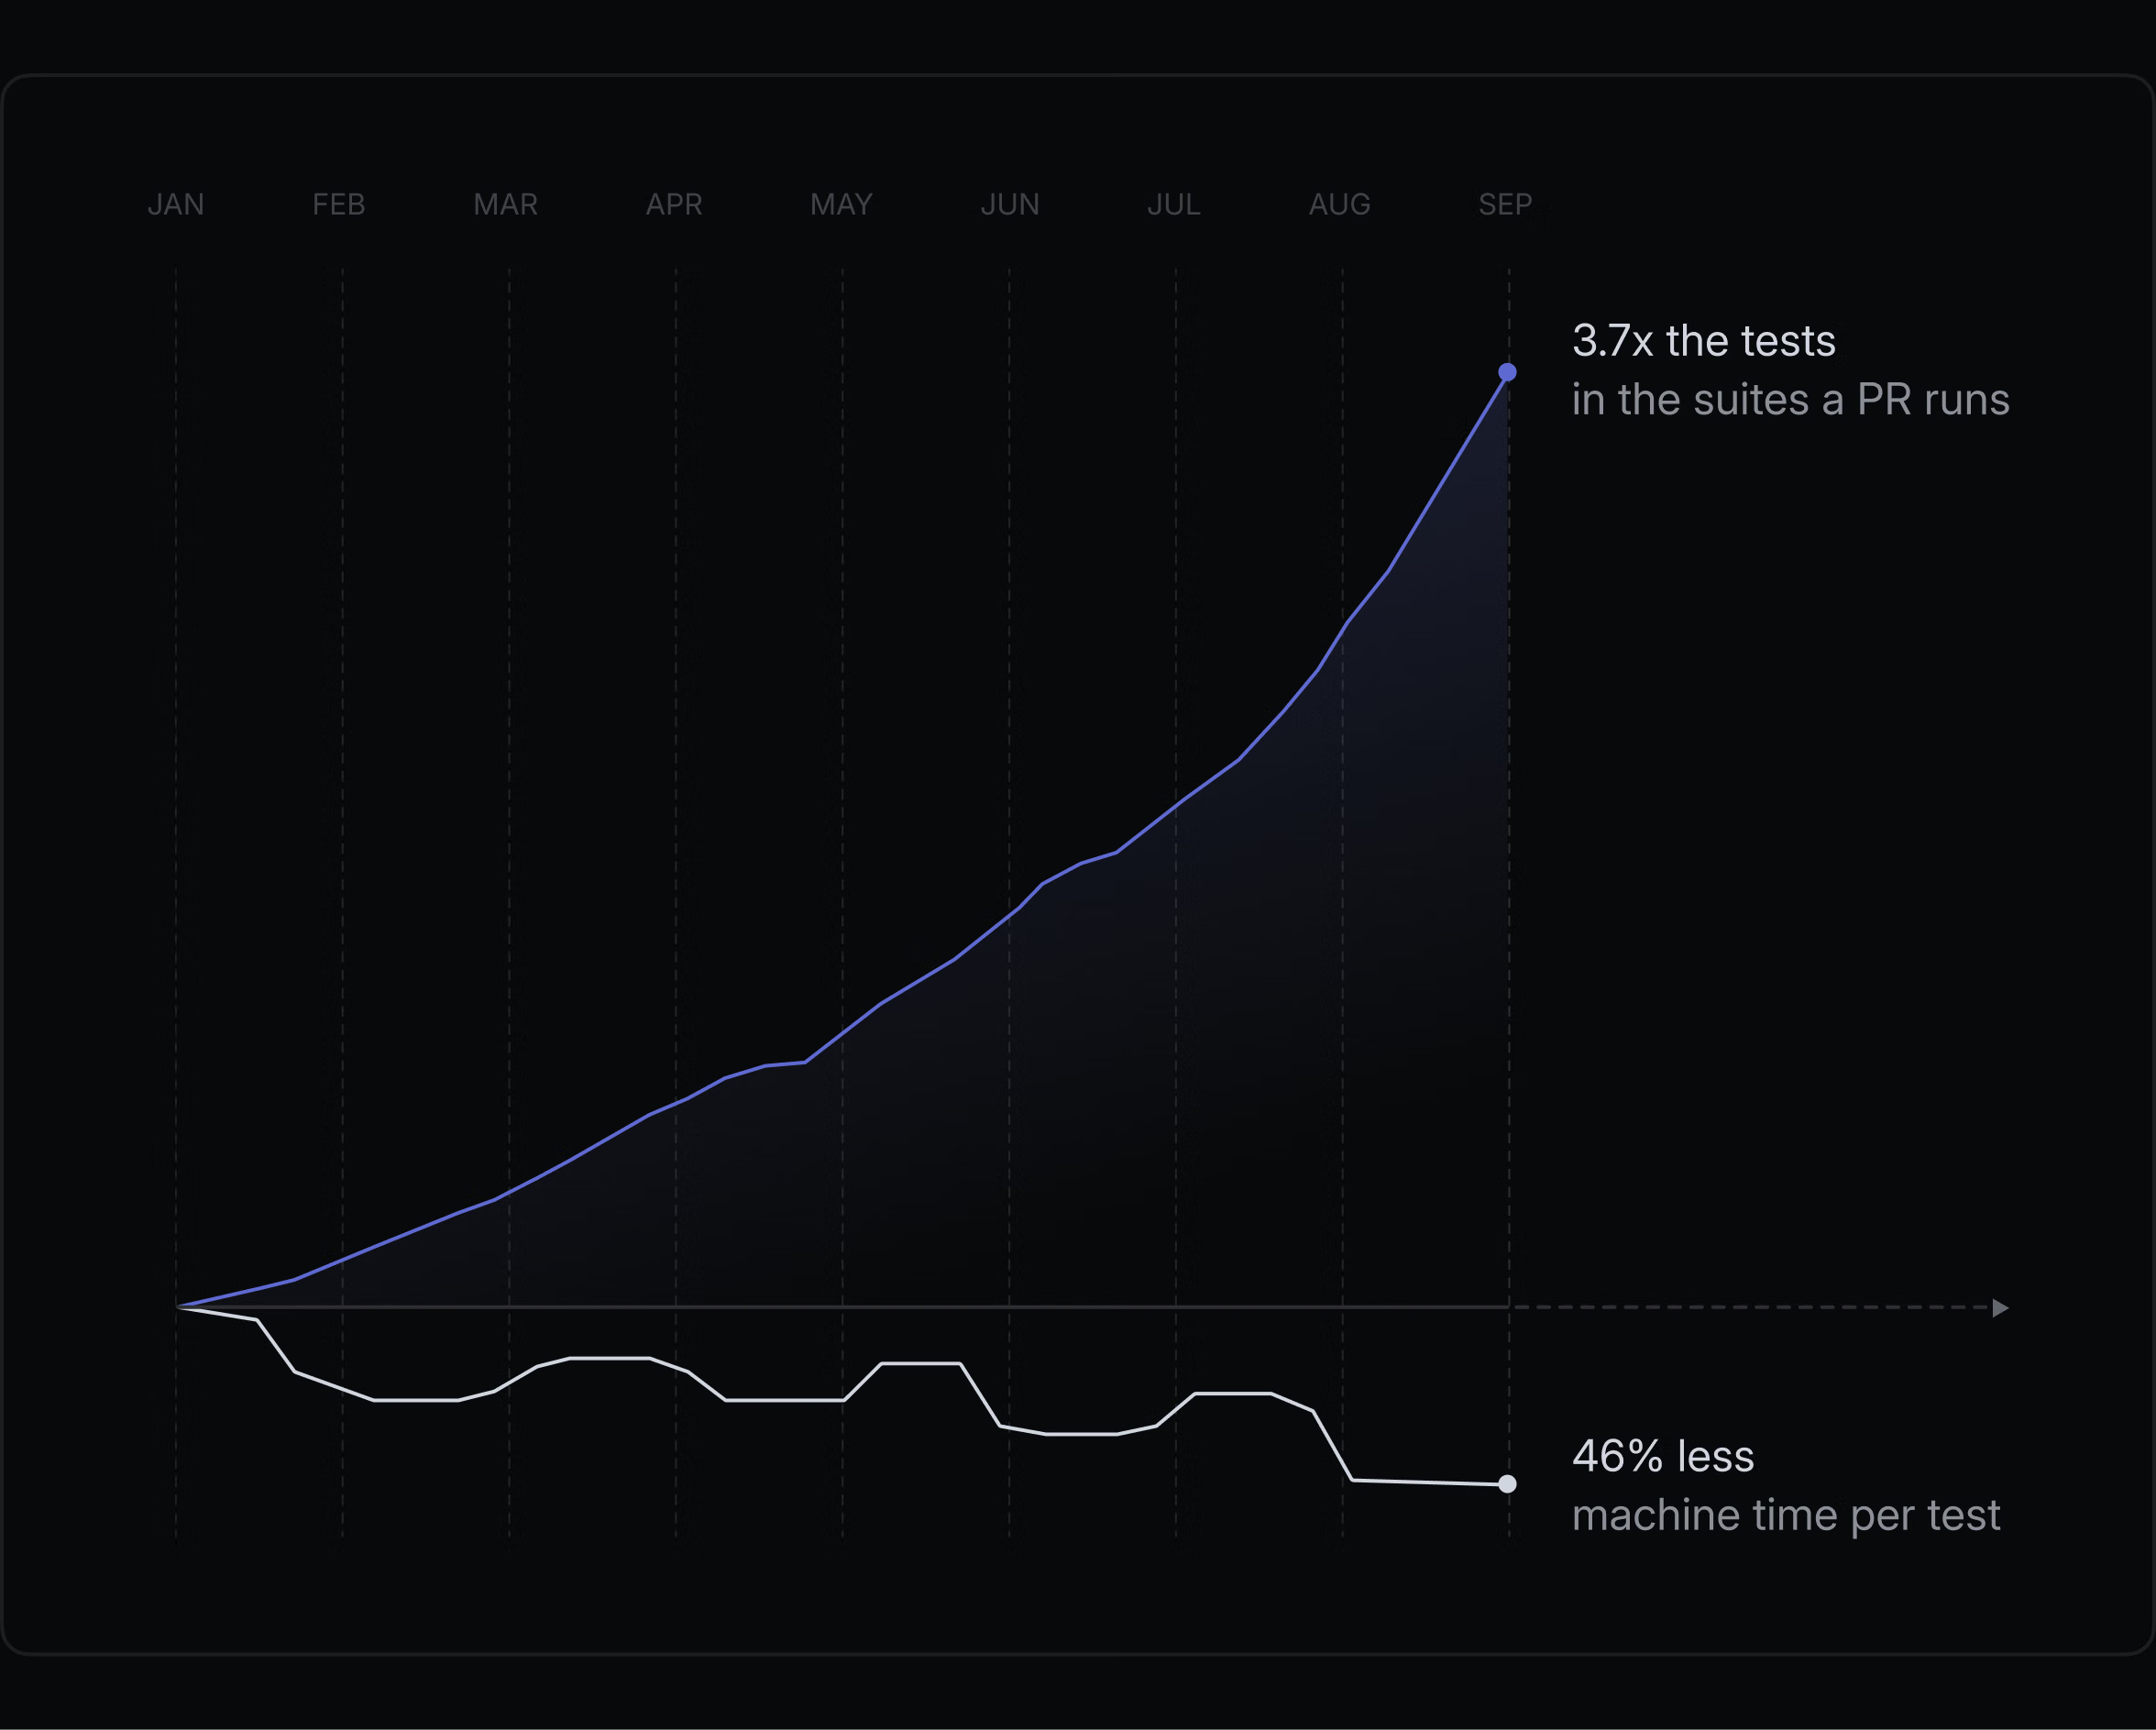
Linear 的测试套件年初至今膨胀了近 4 倍,PR 等待 CI 的时间反而被压低了。
写代码变快了,为什么 PR 反而更慢?因为每条 PR 还是得跑完 CI (持续集成,每次提交后自动跑测试、编译、构建等检查的流水线)。智能体把产出代码这一步的成本压到接近于零,验证这一步没跟上,于是队列就堆在了 CI 上。
今年早些时候,Linear 工程师 Mufeez Amjad 一打开看板,CTO Tuomas 已经给他派了一张工单,标题就一句话:「CI 成本太高。」后面还附了一句:顺便让它跑得更快。
他们盯的是两件事:一条 PR (Pull Request,拉取请求,开发者向主分支提交改动并请求合并的机制) 在 CI 上等多久,以及它烧掉多少 runner 时间。测试量翻着倍往上涨,这两条线却要往下走——靠哪四类动作做到,后面拆。
换机器、换编译器,先把单点最慢的活压下去
三类动作都在流水线结构之外:换更快的 runner、换原生编译器、把 lint 从 TypeScript 类型信息里解耦。它们省时的道理各不相同。
Linear 第一刀下在机器本身。他们把 workload 从 GitHub Actions 迁到第三方 runner——CPU 更快、存储更顺、缓存更稳。代码没动、配置没动,同一条流水线换到更快的硬件上,单项最慢的那批任务就先被压了下去。
第二刀是编译器。Linear 几乎全量是 TypeScript,tsc(TypeScript 官方编译器,逐个文件做类型检查)每周都是瓶颈。tsgo(TypeScript 原生编译器,用 Go 重写后启动和单遍检查更快)省时的道理很直接:类型检查本身是 CPU 密集的活,换一门编译型语言重写,单遍检查的固定开销就下来了。类型检查不再是瓶颈,整个流水线的等待重心也就跟着挪了位。
第三刀是 lint。Linear 一批自定义规则依赖 TypeScript 类型信息——要么靠它做限制,要么靠它做 autofix(编辑器或工具自动按规则修代码)。每跑一次 lint 都要先把全量类型图构出来,lint 因此成了 CI 里最吃内存的作业之一。类型图这一步,就是它慢的根子。
团队把这批规则改写成对抽象语法树(AST,把代码拆成函数、if、return 这类最小语法单元的树状结构)做静态分析,绕开类型信息。ESLint 由此彻底甩掉 TypeScript 依赖,内存也跟着下来。
顺带的好处是后来迁 Oxlint(用 Rust 写的极快 linter,专注语法层规则)变得很省事——只动语法的规则可以直接平移,不用再处理类型耦合。Oxlint 上线后又进一步压低了 lint 的 runner-minutes(CI 机器按分钟计费的总时长)。
卡住 8 个分片的,不是测试,是前面那扇 26 秒的小门
换机器、换编译器(tsc→tsgo)把单个作业压得很猛,但 PR 等 CI 还能不能再快,要看「卡住别人的小门」。Linear 把视角从单个作业抬到整条流水线后,发现瓶颈藏在所有人前面那道变化检测作业里。
每条流水线开头都有一个变化检测作业:判断 PR 改动了哪些路径、要不要跑数据库相关的检查。8 个 API 测试分片(把测试拆成几份并行跑)都在等它给出信号,它卡一秒,后面 8 个分片全晚一秒。
这个作业自己却一直在做多余的事:哪怕只需要改一两个文件,它也会把整个工作树(一份完整的代码副本)拉下来。中位数 26 秒,最慢的一次卡了 94 秒——一道只做判断的小门,比它要放行的任何一道测试都慢。
Linear 做的第一件事是给 fetch 设上限 depth(限制拉取历史深度),把最慢的一次从 94 秒压到 20 秒;第二件事是干脆把 checkout 拿掉,因为有些门控作业根本用不到工作树,从 27 秒掉到 7 秒;第三件事是给那些确实需要 diff(比对代码差异)路径的流程换成 sparse checkout(只取需要的目录),又省下 11 秒出头。
换完机器、换完编译器这些单点优化做完,Linear 把视线抬高到 CI 作为一整个系统来看。CI 的 critical path(关键路径)指那些一旦延迟、整条流水线都得等着的环节,前节已经讲过 tsc、lint、test 各自跑得更快;但还有一个更隐蔽的门:缓存标记的写入位置。Linear 原本把 cache 标记写在「合并前最后一道检查」里,导致测试明明全过了,PR 还要在 merge queue(合并队列)里干等这个写入动作。改成一个非门控的作业去写,合并路径上少掉 42 秒。
门控作业值得先动,前提是它真的卡在关键路径上;一旦它被移出关键路径,再抠它就没有意义了。
node_modules 缓存被废:有时候不缓存比缓存更快
工程师的本能是把能缓存的全缓存起来。Linear 试了一遍,发现 node_modules 是个例外:命中比重新装还慢,干脆把缓存拆掉。
他们的判断很简单:把 node_modules 缓存命中率、用时和重新装依赖的用时排在一起。命中缓存仍需 28 秒,不缓存直接装只需 7.5 秒。差距太大,缓存没存在的理由——废除。
这事指向一个更大的趋势:AI 编码让代码改动变密,CI 的瓶颈从"跑得久"挪到了"启动慢、重复多"。每一份 PR 流水线开始前都要拉一次依赖、克隆一次代码、连一次数据库,这些开销是固定的,不管这次改动是一行还是一个文件。
前几节讲的 Postgres 客户端预装进基础镜像、API 包只装需要的依赖、node_modules 直接不缓存,都是在压这一段固定开销。
对正在搭或改 CI 的人,可操作的观察点更直接:自己拿表量一次"命中缓存的用时"和"不缓存直接装的用时"。命中比不命中还慢,缓存就该拆。这个结论跟"缓存永远好"的经验相反,但在 node_modules 这种依赖树庞大、解压和校验本身就要花时间的东西上,重装的固定成本可能比缓存命中的 IO 成本还低。
能抄的只有这几条,其余先看懂
Linear 的全套优化偏团队工程,能直接落到自己流水线里的只有几条。
先说能直接动手的两条。API 工作流里的 pnpm install,原来 44 到 73 秒,把安装范围收窄到 API 包及其依赖后压到了 16 到 18 秒——单条作业级别的改动,门槛不高。
另一条是 Postgres 客户端:每个分片(test shard)原本要花 7 到 8 秒用 apt 装一遍,改成打进 CI 基础镜像后这笔开销直接消失。两件事都出自主信源对 setup 环节的复盘。
另几条更偏系统层面,复制前要掂量掂量。换第三方 runner 拿到 34% 提速的前提是 GitHub Actions 已成为瓶颈;如果现状不是这样,迁出去未必划算。
换 tsgo(TypeScript 编译器原生版)这种工具链换血更激进,得看团队对编译器版本变化的接受度。把 cache 标记从合并前作业挪到非门控作业这种架构调整,也得先摸清自己的关键路径里到底卡在哪——Linear 靠这套操作在合并路径上砍掉了 42 秒,但这是它家流水线结构特有的结果。
量一遍自己 PR 等待 CI 的中位耗时和 p90,把「到底卡在哪」用数字钉住,再决定动哪条作业。
在 API 或后端工作流里找安装依赖那一步,对比「全量安装」「过滤安装」「命中缓存」三种路径的实际耗时,参考 Linear 砍 node_modules 缓存的判断逻辑。
把每个分片都要 apt 装的运行时(Postgres 客户端、数据库驱动等)打进基础镜像,省下每分片几秒的重复安装。
看关键路径上有没有「先跑完才能跑别的」的小作业,给它加上超时与重试,避免一次卡顿拖住整条流水线。
对换 runner、换编译器、挪 cache 标记这类系统级动作,先在一条非关键工作流上 A/B 跑两天,比对 median 和 p90 再下结论。
信源:Linear Blog《AI coding has made CI a bottleneck, so we reworked ours to keep up》(2026-09-21);口径说明:数据来自 Linear 自家工程团队对自身 CI 流水线的复盘,属厂商自述的内部优化结果,不构成对其他团队或工具链的横向比较。