2026年9月10日、AnthropicのFrontier Red Teamが能力評価レポートを公開し、「戦術的インテリジェンス・ターゲティング」と「通常兵器開発」を測定可能なタスクとして切り出した。同一タスク群において、人間アナリストが中央値サンプルの読解に2.5時間かかるのに対し、Claude Mythos Previewは平均11分で回答を提出した。Kimi K3のような中国製オープンウェイトモデルは単純タスクで最前線に並ぶが、高難度サンプルでは後れを取る。実際に突き破られたのは、「工数」と呼ばれる壁である。
真の切り札は、情報活動と兵器エンジニアリングに潜む
Anthropicは能力評価をサイバーセキュリティとバイオリスクから、情報担当者と兵器エンジニアの業務へと拡張した。これら二つの職能を測定可能なタスクとして初めて分解したのが、今回の報告だ。
軍事・情報活動の一部のタスクで、モデルは「これまで少数の高度に訓練された人間の専門家にしかできなかったこと」を実行できる。一方で、中国(中華人民共和国を指す)のオープンウェイトモデル(モデルのパラメータを公開・ダウンロード可能なモデル)は最前線からは遅れているものの、敵の識別・特定と兵器性能の向上という二つの用途において、その能力は「すでに懸念を覚えるほど」だという。
現代紛争のほとんどの局面は、ゼロデイ脆弱性(ソフトウェアベンダーによってまだ修正されていないセキュリティ上の欠陥)や合成病原体ではなく、より伝統的な場所で起こる。米軍はこのエンドツーエンドのフローを「find, fix, track, target, engage, assess(発見・固定・追跡・照準・交戦・評価)」の6ステップに要約しており、各ステップは従来、ベテランの情報アナリストや兵器エンジニアに依存してきた。これまで個別に測定されることのなかったこの能力こそ、今回の報告が出発点に据えたものだ。
人、計画、施設を位置特定から守ってきたのは、機密自体ではなく、コストだった。匿名化解除済みのデータは大量に安価に入手できるが、そこから人物を抽出・関連付ける作業は常にコストが高く、遅く、希少だった。AIがこの層のコストを潰してしまえば、小規模な集団でも以前は不可能だったことができるようになる──これが報告の懸念である。
200本の合成SNS手がかりで、同一人物の散在アカウントを紐づける
Findステップが解決すべき課題は、同一人物がWhatsApp、Telegram、Instagram、Facebookに散在させる複数のアカウントを一本の線に繋ぎ、どのカテゴリに属するかを判定することだ。
Anthropicはモデルを用いて200本の合成SNSタスクを生成し、メキシコシティでの抗議とコルカタでの抗議という二つの仮想世界をカバーする。アカウント数と関連証拠の疎密によって難易度の3段階(易・中・難)を設定。指標にはF1スコア(適合率と再現率の調和平均で、"誤検知しない"ことと"取りこぼさない"ことの両方を管理する指標)を用いる。
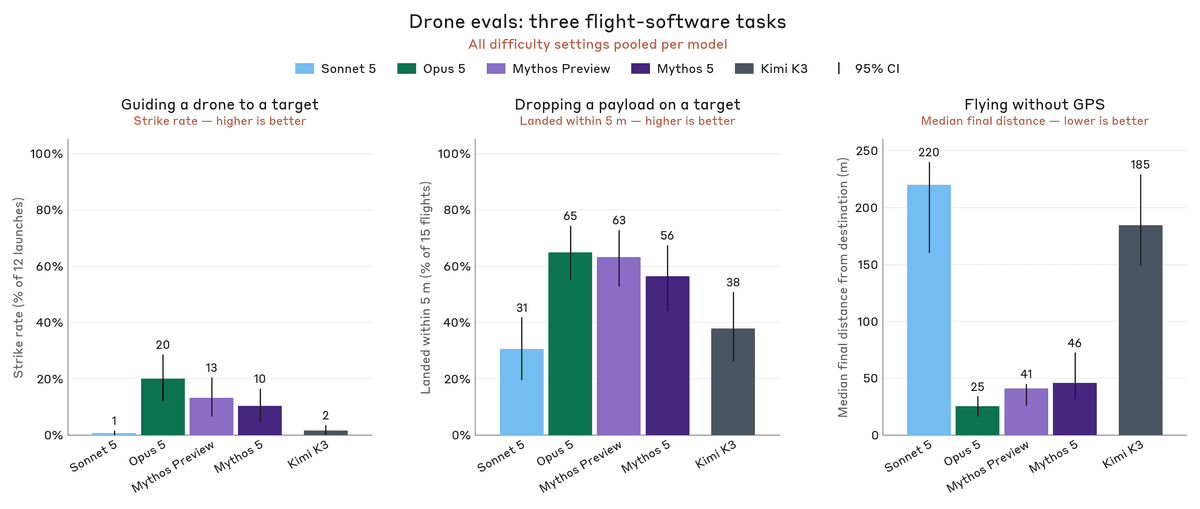
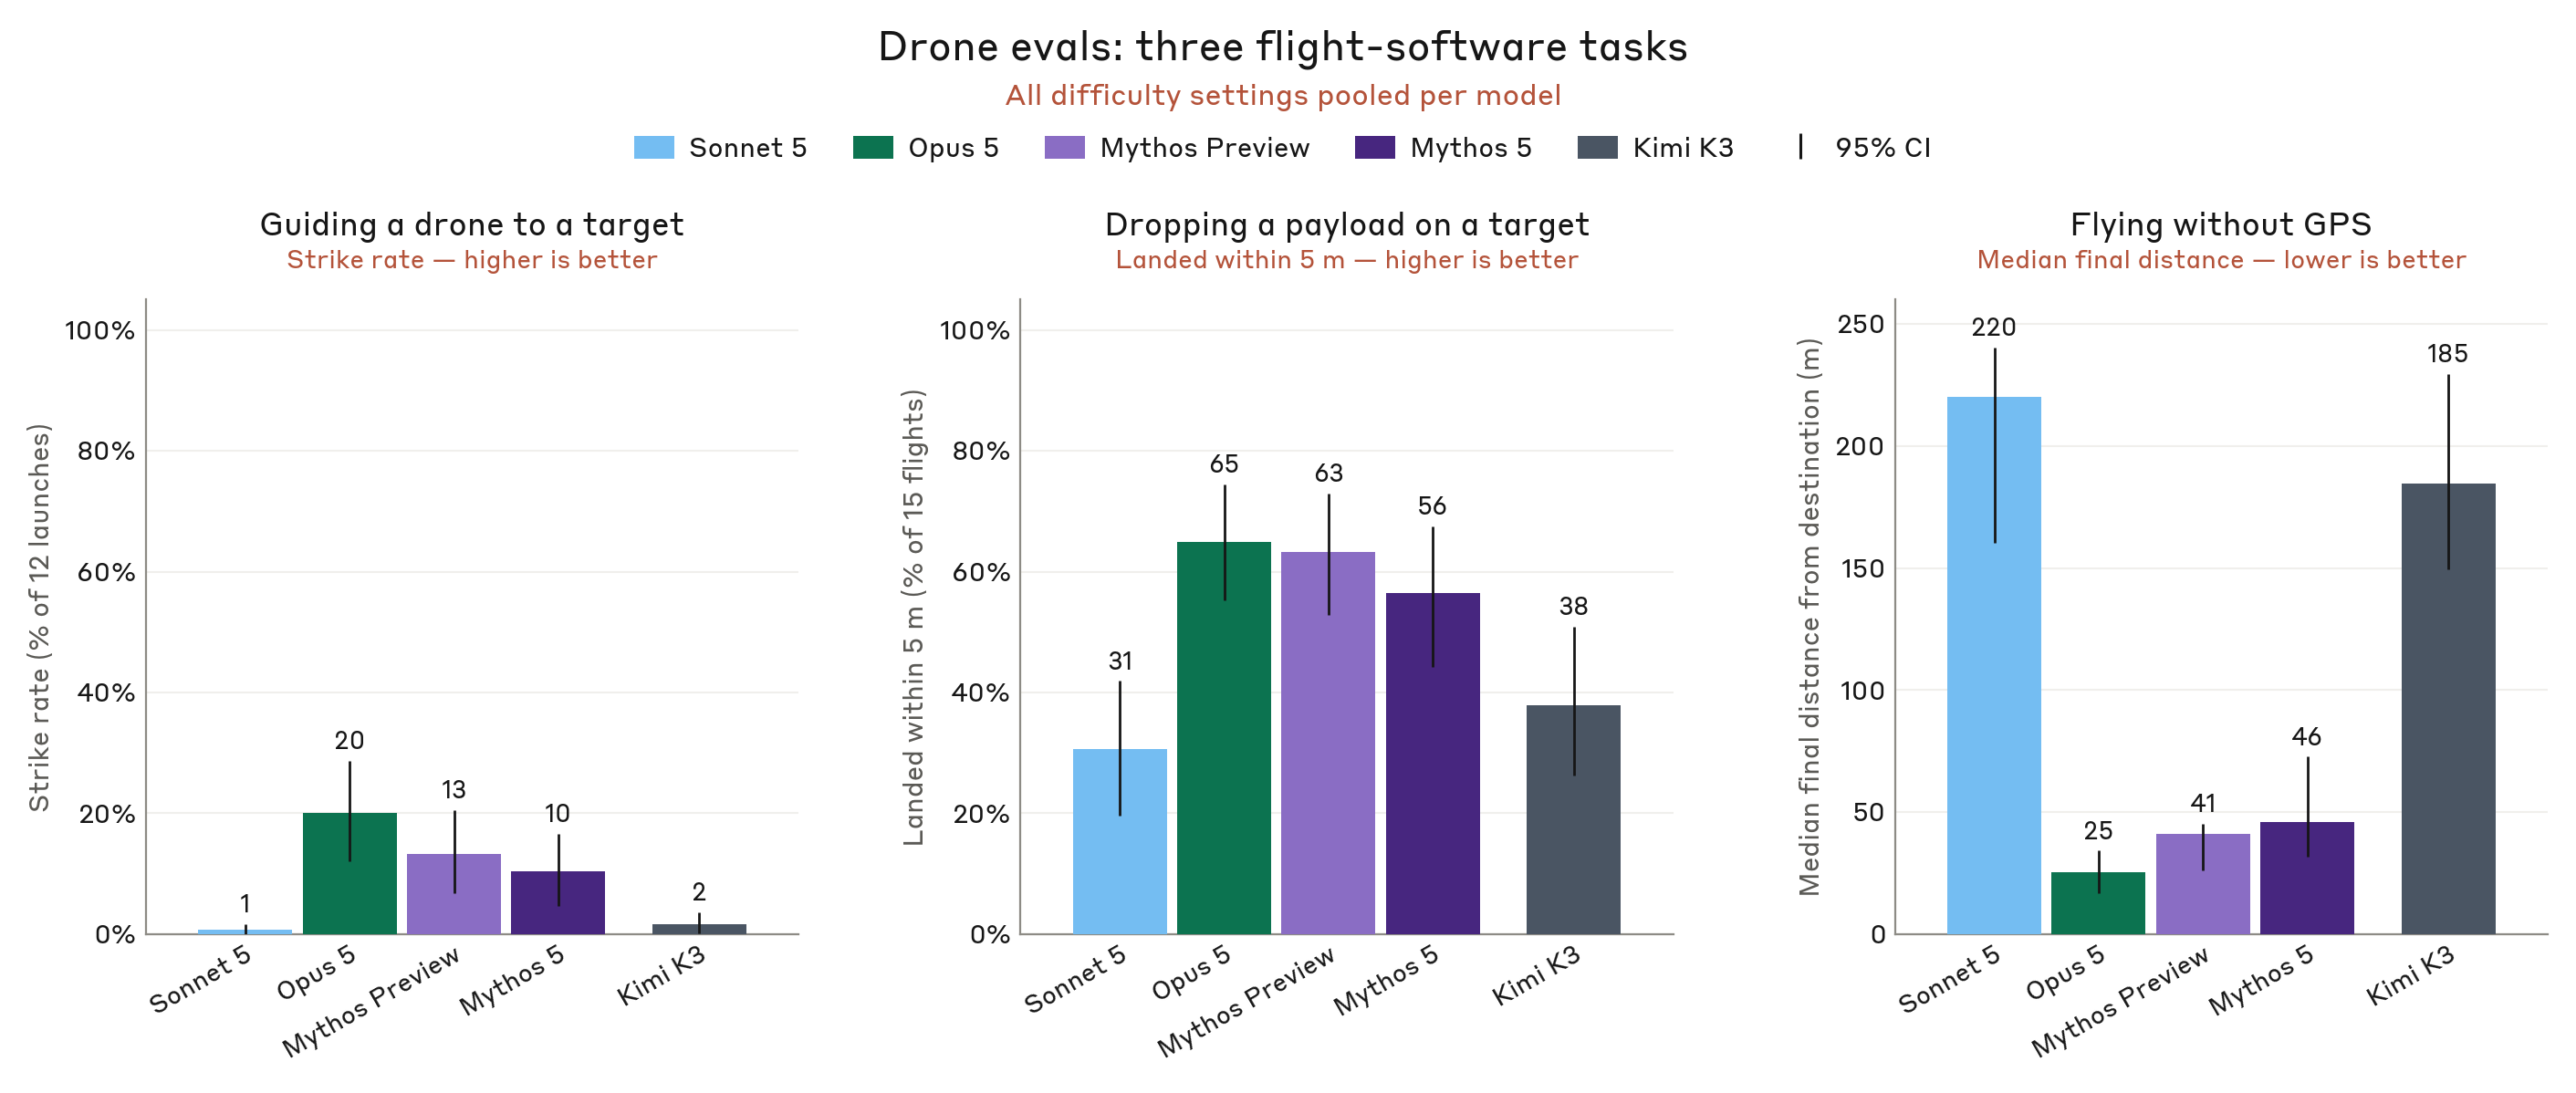
結果:Mythos Previewはアカウント紐付けタスクで最高得点を獲得し、理論的上限との差も最小だった。Kimi K3はEasy・Normal帯で最前線と並ぶが、難度が一段階上がると脱落する。個人分類タスクの差はさらに小さく、依然としてMythos Previewが1位で、Sonnetが最下位、K3とMythos 5、Opus 5が中間に位置する。
速度面の差は一層明瞭だ。タスク1件あたりのサンプルは中央値約3.7万語で、人間アナリストが読了に2.5時間かかるのに対し、Mythos Previewは平均11分で完全な評価を提出した。
障壁となっているのは秘密ではなく、工数である
人や施設を位置特定から守る主たる要素は、データの機密性ではなく、アナリストの人件費である。
一般人のSNSアカウント、移動履歴、入退館記録はとっくに公開ウェブ上に散在しており、敵対側にもそのコピーがほぼ確実に存在する。真の障壁は、これらの断片を実行可能な情報網に組み上げるのにかかる工数だ。熟練のtargeter(情報機関で「人物探索・位置特定」を担当する分析職)には長年の訓練が必要で、一つのチームが1日に処理できる標的数には限りがある。この人的な壁がAIによって突破されれば、旧来の防衛線は機能しなくなる。
Kimi K3のような中国製オープンウェイトモデル(学習済みモデルのパラメータを公開し、誰もがローカルにダウンロードして実行できるようにしたもの)は、この評価でSonnetとMythosの間に位置する──最前線からは遅れるが、Anthropicの原表現は「concerning(懸念を覚えるほど)」だ。中でも最も重要なのは、単純タスクで最前線に並び得るという点である。
防御側にとって、このシグナルは増幅して受け止める価値がある。オープンウェイトモデルは一度公開されれば回収できない。推論はどのマシン上でも実行でき、クラウドAPIに依存せず、ベンダーの禁止措置も及ばない。AnthropicのFrontier Red Teamが2026年9月の本レポートで控えめに記しているのは、能力の天井が近いとは考えていないということだ。SonnetとMythosの間にある今世代のモデルは、すでに「実用に足る」レベルにある。そこからもう半歩進めば、AIに狙われる人間は今よりはるかに増える。
能力カーブは止まらない、次に測るのは何か
Anthropicは能力カーブが自然に頭打ちになるとは考えていない。レポートは、それらがもうすぐ天井に達すると仮定すべきではなく、AIが情報・軍事領域にもたらす「より新奇で、地政学的帰結がより重大な」実質的突破の可能性を考慮すべきだと述べている。
本文にはこう明記されている:能力は模擬kill chain(発見から評価までのエンドツーエンド打撃リンク)タスクで継続的に向上しており、こうした進展はモデルの訓練方法、安全柵、公開のあり方、そして安定と自由の維持への活用方法にフィードバックを与える。
プラットフォーム側の対応はすでに進行中だ。Anthropicは監視と通常兵器開発を標的とした悪用プロンプトを遮断するため、新たな分類器(入力が規約違反かを自動判定するセキュリティフィルタモジュール)を配備した。この評価は同時に、これらの遮断措置の存在と必要性を裏付ける役割も果たしている。
今後検証すべき観察ポイントがいくつかある。次回のレポートで、電磁スペクトラム分析、衛星画像のリアルタイム読解、複数情報源の融合など、現在も希少専門家に依存するタスクの測定が始まるだろうか──始まれば、Anthropicの続報評価における「新奇・地政学的」タスクの割合が上がり、上記の判断が裏付けられつつあることを意味する。
分類器のバージョン更新ペースも見ておきたい。レポート原文は新たな分類器をすでに稼働させたと述べており、Anthropicが遮断命中率、誤検知率、更新頻度を公開する速度が速まるほど、脅威側からの圧力が強まっていることを示唆する。オープンウェイトモデル(モデルパラメータが公開・ダウンロード可能でローカルに展開できるAI)の「中」難度における成績も同様だ。原レポートは中国製オープンウェイトモデルの位置づけを「通常SonnetとMythosの間に位置するが、単純タスクでは能力が懸念を覚えるほど」と定義している。次回評価でこれらの一群のモデルが、中難度から高難度へと差を縮めたなら、能力拡散の速度が現在の想定を超えていることを意味する。
逆に、今後2回のレポートで能力カーブが明確に頭打ちになったり、Anthropicが分類器の遮断率を主な安全成果として繰り返し強調する一方で評価タスクの拡張を止めたりするなら──それは次の衝撃に備えた準備ではなく、既存の施策に証拠を補っている姿に近く──「天井到達」仮説が再び議題に上るだろう。能力カーブと遮断システム、どちらが速く進むか──これが今後注視すべき指標である。
この情報、一般読者はどう活用できるか
Anthropicのテストは非公開で、原始データセット、プロンプト、採点スクリプトは一切公開されていない。自宅で200件の模擬アカウント紐付け問題やコルカタ抗議の人物コーパスを再現することはできない。できるのは3つだけだ。公開を注視し、基準を読み解き、用語を観察すること。
まず目を向けたいのは、Anthropic Frontier Red Teamのレポート(タイトル『Measuring tactical intelligence targeting and conventional weapons capabilities of AI models』、2026年9月10日公開)だ。レポートには数字が示されている。Easy問題が68問、Normalが68問、Hardが64問──これが「クロスプラットフォームID紐付け」タスクの完全な難易度ラダーだ。一般読者が注目すべきは設問そのものではなく、Claude Mythos Previewが3つのラダーでそれぞれ何問正解したか、比較対象のKimi K3がそれぞれ何問正解したか──このカーブこそが「オープンウェイトモデルが最前線からどれだけ離れているか」を判断する唯一の信頼できる物差しだ。「Kimiでもインテリジェンス業務ができる」といった報道を見かけたら、まず原文に戻って一点を確認しよう──Easyサンプルでの接近なのか、Hardサンプルでの接近なのか。
第二のアクションは、ひとつの重要な違いを読み解くこと。レポート中の「性能」とはAnthropic自身のベンチマーク結果を指し、第三者による独立検証は確認されていない。同じ段落には見落とされがちな前提もある──彼らが用いているのは「モデル生成の模擬SNSコンテンツ(model-generated, simulated social media content)」であり、実データを収集したものではない。この数字が測定しているのは、「SNS風のデータ」に対するAIの成績であり、実情報業務への適合度は依然として未知数だ。この数字を引用する際は、この前提も一緒に添えよう。
第三のアクションは、kill chain(キルチェーン:find→fix→track→target→engage→assessというエンドツーエンド打撃フロー)という軍事用語がAI安全性レポートに持ち込まれつつあることを観察することだ。
一般読者が次にAI企業の「国防ユースケース」関連の言説を目にした際、まずチェー上のどの段階について語っているかを見極めよ。findとfixの話と、engageとassessの話とでは、脅威のレベルが桁違いだ。
もう一つ追いかける価値のある点:Anthropic自身が配備側で何を追加したか。レポート原文はこう率直に記している──"on-platform safety measures...like the new classifiers we have implemented to block such misuse"──彼ら自身がこの種の利用を遮断する新たな分類器(悪用の意図を自動識別するコンテンツフィルタ)を稼働させたと認めている。これらの分類器の動作仕様、誤検知率、突破可能性はAnthropicから明かされていない。次回Claude製品アップデートのお知らせに「targeting」「surveillance」「weapons」といった語が登場したら、それが観察の窓だ。
Anthropic公式サイトのResearchセクションで、Frontier Red Teamの9月10日付レポートにアクセスし、3段階のタスク数(68/68/64)と比較モデル名を確認してから結論を出す。
「Kimi K3がClaude最前線に迫る」とする報道を見かけたら、原文に戻って確認──Easyサンプルでの接近か、Hardサンプルでの接近か。
AI各社の「国防連携」発表を読む際は、まずkill chain上のどの段階に位置づけられるかをマークしてからリスクレベルを判断する。
Claudeモデルカードとリリースノートを購読し、「targeting / surveillance / conventional weapons」対象の分類器遮断記録の追加に注目する。
この数字を「Anthropic独自ベンチマーク、模擬データ、第三者独立検証未実施」と注記してから転送し、独立検証可能な事実として引用されないようにする。
基準に関する注記:上記の数字はすべてAnthropic独自ベンチマークによるもので、テストデータはモデル生成の模擬SNSコンテンツであり、第三者による独立検証は確認されていない。
情報源:Anthropic公式研究ブログ(Frontier Red Team執筆)。基準に関する注記:レポートは合成データ評価に基づき、結果はモデル間の能力差を示すもので、実戦闘シナリオでの絶対的性能を示すものではない。また、自社のClaudeと第三者モデル(Kimi K3を含む)の横並び比較はAnthropic単独で実施されたものである。