2026 年 9 月 10 日,Anthropic 的 Frontier Red Team 发布能力评估报告,把「战术情报定位」和「常规武器开发」拆成可测任务。同一批任务里,人类分析师读完一份中位样本要 2.5 小时,Claude Mythos Preview 平均 11 分钟交卷。Kimi K3 这类中国开源权重模型在简单任务上追平前沿,高难度样本上掉队。真正被砸穿的,是那堵叫「工时」的墙。
真正的杀招,藏在情报与武器工程里
Anthropic 把能力评估从网络安全和生物风险,扩到情报员与武器工程师的活儿——这份报告第一次把这两类人的工作拆成可测任务。
报告称:在军事和情报的某些任务上,模型已经能干「过去只有少量受过高级训练的人类专家才能干的事」。它同时承认,中国(此处指中华人民共和国)的开源权重模型(模型参数公开可下载的模型)虽落后于前沿,但在识别和定位对手、提升武器性能这两件事上,能力「已经够让人担心」。
现代冲突的大多数环节并不发生在 0day 漏洞(尚未被软件厂商修补的安全漏洞)或合成病原体里,而是发生在更传统的地方。美军把这条端到端的流程概括为「find, fix, track, target, engage, assess」六步,每一步过去都依赖资深情报分析师或武器工程师。这类能力此前没被单独测过,就是这份报告的出发点。
Anthropic Threat Intelligence Team 同期报告显示,威胁行为者正在用 AI 做监视和常规武器开发,并已经尝到了甜头。
保护人、计划和设施不被定位的,从来不是秘密本身,而是成本:海量的去匿名化数据廉价可得,但把人肉从这些数据里筛出来、关联起来,一直是贵的、慢的、稀缺的活儿。报告担心:一旦 AI 把这层成本打掉,小团体也能做以前做不了的事。
200 条合成社媒线索,把同一人的散落账号串起来
Find 步骤要解决的,是把同一个人散落在 WhatsApp、Telegram、Instagram、Facebook 上的多个账号串成一条线,再判定他属于哪一类。
Anthropic 用模型生成 200 条合成社媒任务,覆盖墨西哥城抗议与加尔各答抗议两套虚构世界,分易中难三档,难度由账号数量和关联证据稀疏度决定。指标用 F1(精确率与召回率的调和平均,同时管"别抓错"和"别漏掉")。
结果是:Mythos Preview 在账号关联任务上得分最高,与理论上限的差距也最小。Kimi K3 在易、中档和前沿持平,档位一难就掉。个体分类任务差距更小,Mythos Preview 仍排第一,Sonnet 垫底,K3 与 Mythos 5、Opus 5 居中。
速度上的差距更直观。单任务中位样本约 3.7 万词,人类分析师读完要 2.5 小时,Mythos Preview 平均 11 分钟出完整评估。
挡在前面的不是秘密,是工时
Anthropic 自己的话说得很直白:保护人和设施免于被定位的,主要不是数据保密,而是分析师的人力成本。
普通人的社交账号、出行轨迹、门禁记录早就散落在公开网页上,敌对方手里也大概率存着一份。真正挡在中间的,是把这些碎片拼成一张可行动情报网所花的工时。一个成熟的 targeter(情报机构里负责"找人、定位"的分析岗位)需要多年训练,一个团队一天能处理的目标数量有限。这道人力墙一旦被 AI 砸穿,旧的防线就失效了。
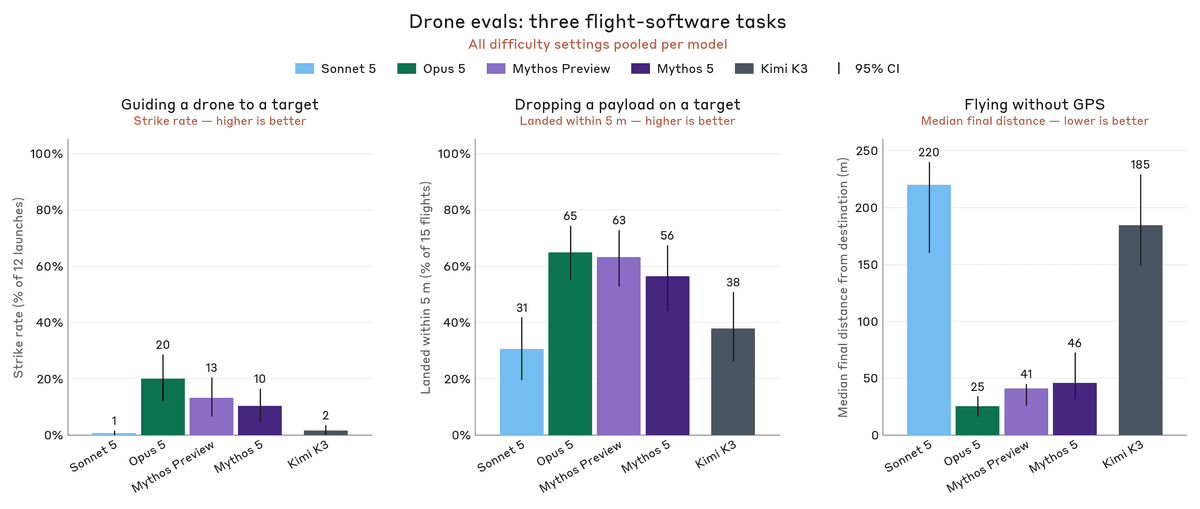
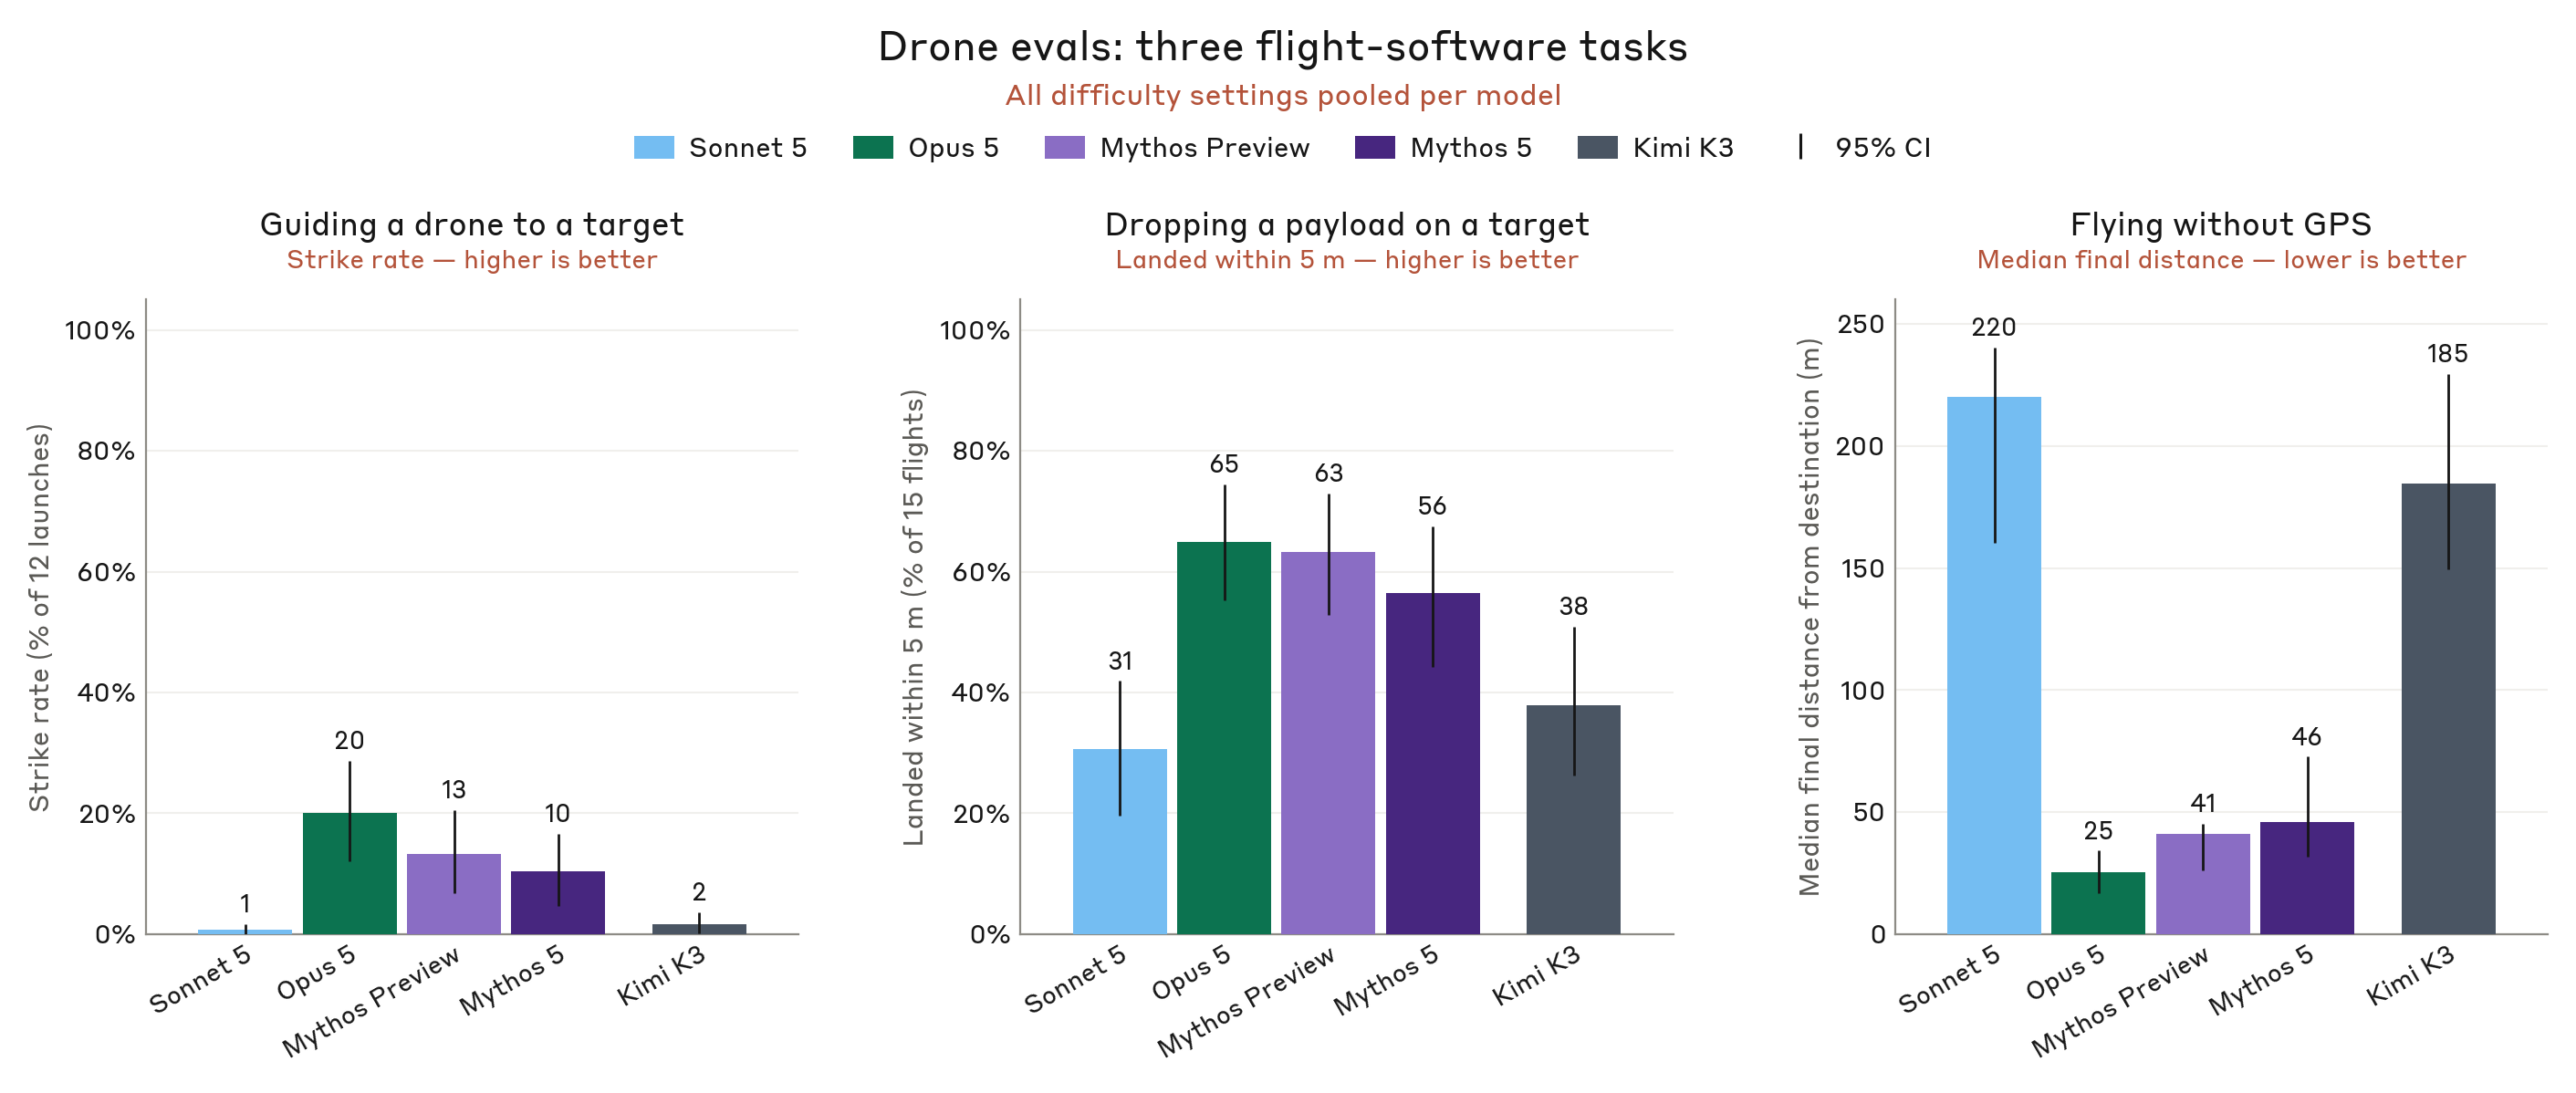
中国开发者的开源权重模型(把训练好的模型参数公开发布,谁都能下载到本地跑)在 Anthropic 这套测评上整体落在 Sonnet 和 Mythos 之间——落后于前沿,但 Anthropic 的原话是"concerning"(令人担忧)。其中最关键的一条:Kimi K3 这类模型在简单任务上能追平前沿。
对防守方来说,这条信号值得放大。开源权重模型一旦发布就没法收回——推理可以在任何一台机器上跑,不依赖云端接口,不受厂商封禁。Anthropic 的 Frontier Red Team 在 2026 年 9 月这份报告里写得克制:他们不认为能力会马上见顶。Sonnet 到 Mythos 之间的那批模型,今天已经"够用";再往前走半步,能用的人会更多。报告同时点出,这种扩散可能让原本无力自建情报流程的小型威胁主体也具备类似的 workflow,也会让资源充足的国家把手里的数据吃干榨净。被 AI 盯上的人,会比今天多得多。
不指望撞顶,新动作可能直接上强度
Anthropic 不认为能力曲线会自己平掉。报告的原话是:不应假设它们即将触顶,应考虑 AI 在情报与军事领域带来「更新颖、地缘战略后果更严重」的实质性突破的可能性。
文中明确写道:能力在模拟的 kill chain(从发现到评估的端到端打击链路)任务上正在持续进步;这些进展会反过来影响模型应如何训练、加护栏、发布,以及如何用于维护稳定与自由。
平台侧的应对已经在做:Anthropic 部署了新的分类器(自动判定输入是否违规的安全过滤模块),用于拦截针对监视与常规武器开发的滥用提示;这份评估同时也是为这些拦截措施的存在与必要性背书。
后续有几个可验证的观察点。看 Anthropic 后续评估里「新颖、地缘战略」类任务的占比——如果下一份报告开始测度例如电磁频谱分析、卫星图像实时解读、多源情报融合这类当前仍依赖稀缺专家的任务,说明判断正在兑现。
看拦截分类器的版本更迭节奏。报告原文称已上线新分类器,Anthropic 公开披露拦截命中率、误杀率与更新频次的速度越快,说明威胁侧压力在加大。再看开源权重模型(模型参数公开可下载、可本地部署的 AI)在「中等」难度上的表现——原文把中国开源模型定位为「通常介于 Sonnet 与 Mythos 之间,但在简单任务上能力令人担忧」,如果下一轮测评里这一档模型把差距从中等难度扩展到高难度,意味着能力扩散的速度超出当前假设。
反过来,如果未来两份报告的能力曲线出现明显走平,或者 Anthropic 把分类器拦截率作为主要安全成果反复强调而不再扩展测评任务面——更像是在为现有措施补证据,而非为下一轮冲击做准备——「撞顶」假说会重新进入议程。能力曲线和拦截系统,谁跑得更快,这才是接下来值得盯的指标。
这条情报,普通读者能怎么用它
Anthropic 的测试是闭门的,原始数据集、提示词、计分脚本都没公开。你没法在家复刻那 200 个模拟身份关联题、那张 Kolkata 抗议人物语料。能做的只有三件事:盯发布、对口径、看术语。
先盯一份东西:Anthropic Frontier Red Team 那篇报告(标题《Measuring tactical intelligence targeting and conventional weapons capabilities of AI models》,2026 年 9 月 10 日发布)。报告里给了一组数字,68 道容易题、68 道中等、64 道困难,构成"跨平台身份关联"任务的完整难度阶梯。普通读者盯的不是题目本身,而是 Claude Mythos Preview 在三个阶梯上分别答对多少、对比组 Kimi K3 又分别答对多少——这条曲线就是判断"开源权重模型离前沿还差多远"的唯一可信刻度。看到"Kimi 也能做情报"这类转述,先回到原文确认一件事:是容易样本上的接近,还是困难样本上的接近。
第二个动作是读懂一个关键区别:报告里"性能"指的是 Anthropic 自家跑分,没见第三方独立复测。同一段话还有一句容易被忽略的前提——他们用的是"模型生成的模拟社媒内容"(model-generated, simulated social media content),不是真实抓取。数字衡量的是 AI 在"看起来像社交媒体的数据"上的表现,离真实情报场景的拟合度还是未知数。引用这组数字时,记得把这个口径一起带上。
第三件事,是观察"kill chain"(杀伤链,即 find→fix→track→target→engage→assess 这套端到端打击流程)这个军事术语正在被搬进 AI 安全报告。
普通读者下次看到任何 AI 公司谈"国防用例",先扫一眼它在讲链上哪一环:讲 find 和 fix 的,跟讲 engage 和 assess 的,威胁级别不在一个量级。
还有一条值得追:Anthropic 自己在部署侧加了什么。报告原文写得很直白:"on-platform safety measures...like the new classifiers we have implemented to block such misuse"——他们承认已经上线了新的分类器(自动识别滥用企图的内容过滤器)来拦截此类使用。这些分类器怎么工作、误杀率多少、会不会被绕过,Anthropic 没说。下一次 Claude 产品更新日志里出现"targeting"、"surveillance"、"weapons" 这类词,就是观察窗口。
打开 Anthropic 官网 Research 栏目,定位 Frontier Red Team 那篇 9 月 10 日报告,核对三个难度档的任务数(68/68/64)和对比模型名字,再下结论。
看到任何"Kimi K3 接近 Claude 前沿"的转述时,回到原文确认:是容易样本上的接近,还是困难样本上的接近。
下次读 AI 公司"国防合作"通稿,先标出它落在 kill chain 的哪一环,再判断风险等级。
订阅 Claude 模型卡和发布说明,留意是否新增针对"targeting / surveillance / conventional weapons"的分类器拦截记录。
把这组数字标上"Anthropic 自家跑分、模拟数据、未见第三方复测"的脚注再转发,避免被人当作可独立验证的事实引用。
口径说明:以上数字均出自 Anthropic 自家跑分,测试数据为模型生成的模拟社媒内容,未见第三方独立复测。
信源:Anthropic 官方研究博客(Frontier Red Team 撰写);口径说明:报告基于合成数据测评,结果反映模型间能力差异,而非真实作战场景下的绝对表现,且对自家 Claude 与第三方模型(含 Kimi K3)的横向对比由 Anthropic 单方完成。